


آنچه خواهید خواند
- جدول تصمیم سریع
- تفاوت معماری؛ سیستم کامل در برابر کارت گرافیک
- حافظه؛ جایی که GX10 برتری روشن دارد
- مدل 8B تا 32B؛ RTX 5090 یا GX10؟
- مدل 70B و 120B؛ انتخاب به نفع GX10 تغییر میکند
- پهنای باند حافظه و سرعت Token
- توان برق و خنککاری
- Windows و نرمافزارهای عمومی؛ مزیت ورکاستیشن RTX
- Linux و محیط استاندارد AI؛ مزیت GX10
- Cloud چه زمانی برنده است؟
- Cloud چه زمانی گران یا پرریسک میشود؟
- هزینه واقعی RTX 5090 فقط قیمت کارت نیست
- فرمول ساده نقطه سربهسر Cloud
- مقایسه برای RAG و دستیار سازمانی
- مقایسه برای تولید تصویر و ویدئو
- مقایسه برای Fine-tuning
- ریسک خرابی و تداوم کار
- کدام گزینه برای چه کسی مناسبتر است؟
- چکلیست انتخاب نهایی
- سوالهای متداول
- پیشنهاد مطالعه
- کلام آخر
مقایسه ASUS Ascent GX10 با RTX 5090 و GPU ابری، کدام بهتر است؟
در مقایسه ASUS Ascent GX10 با RTX 5090 و GPU ابری، یک برنده برای همه وجود ندارد. GX10 با 128GB حافظه یکپارچه برای اجرای محلی مدلهای بزرگی طراحی شده که در حافظه 32GB کارت RTX 5090 جا نمیشوند. ورکاستیشن RTX 5090 در بسیاری از پردازشهای سریع، تولید تصویر، ویدئو، رندر و نرمافزارهای Windows انعطاف بیشتری دارد. GPU ابری نیز برای آموزش سنگین، چند GPU و بار کاری مقطعی بدون خرید سختافزار مناسبتر است.
انتخاب درست به چهار سؤال بستگی دارد: مدل شما چقدر حافظه میخواهد، بار کاری چند ساعت در ماه اجرا میشود، داده اجازه خروج از سازمان دارد یا نه و نرمافزار اصلی با Linux/Arm64 سازگار است یا به Windows/x86 نیاز دارد. اگر این چهار مورد روشن نباشید، مقایسه TOPS، FLOPS یا قیمت خرید میتواند نتیجه اشتباهی بدهد.
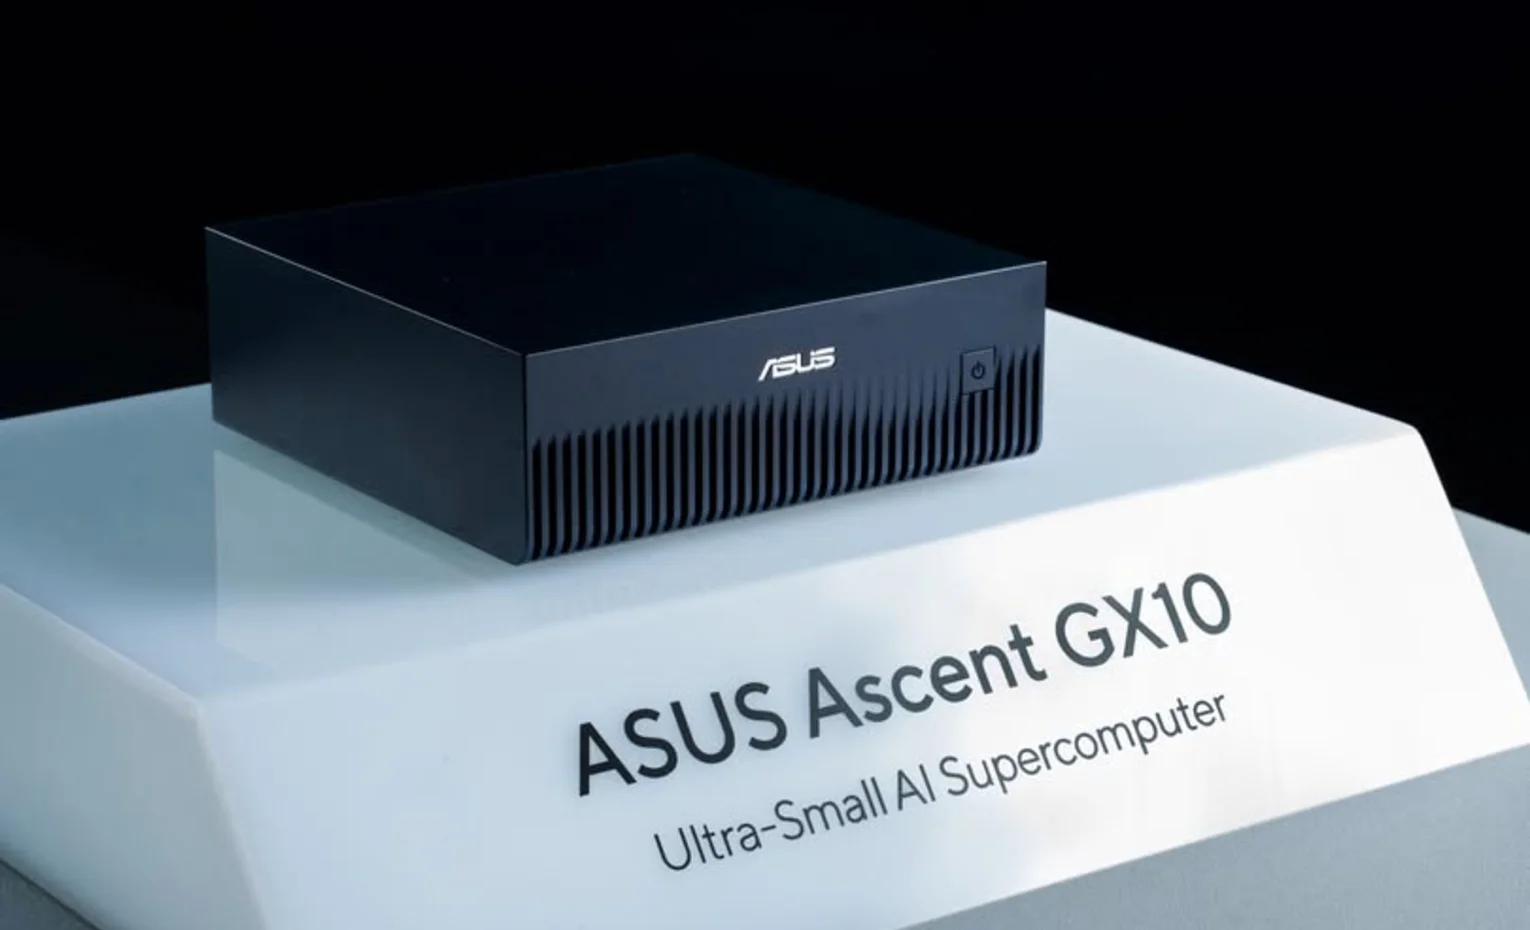
ورک استیشن هوش مصنوعی ایسوس مدل Ascent GX10 و RTX 5090 هر دو به نسل Blackwell مربوطاند، اما برای دو نقش متفاوت ساخته شدهاند. GX10 یک سیستم کامل با NVIDIA GB10 Grace Blackwell و DGX OS است؛ RTX 5090 یک کارت گرافیک 32GB است که به CPU، رم، مادربرد، پاور و خنککننده جدا نیاز دارد. برای شناخت پایه GX10، مطلب پردازنده GB10 انویدیا زمینه مناسبی ارائه میکند.
جدول تصمیم سریع
| معیار | ASUS Ascent GX10 | ورکاستیشن RTX 5090 | GPU ابری |
|---|---|---|---|
| حافظه در دسترس AI | 128GB حافظه یکپارچه مشترک CPU/GPU | 32GB GDDR7 روی کارت؛ رم سیستم جداست | وابسته به Instance؛ از GPUهای کوچک تا H100/H200 و چند GPU |
| مدل بزرگ محلی | مناسبتر برای 70B و مدلهای کوانتیزه بزرگتر | برای مدلهای کوچک و متوسط؛ 70B معمولاً به Offload یا چند GPU نیاز دارد | با انتخاب GPU و تعداد مناسب قابل توسعه است |
| سیستمعامل و معماری | DGX OS مبتنی بر Linux و CPU Arm64 | معمولاً Windows یا Linux روی x86 | اغلب Linux؛ معماری و Image قابل انتخاب |
| حریم خصوصی | پردازش محلی و کنترل بیشتر بر مسیر داده | محلی و قابل کنترل | نیازمند تنظیم امنیت، منطقه و قرارداد پردازش داده |
| هزینه | خرید اولیه و هزینه برق/نگهداری | هزینه کل سیستم، برق بیشتر و قطعات جدا | پرداخت زمانی، Storage، شبکه و عملیات |
| مقیاسپذیری | اتصال چند GX10 با ConnectX-7 | محدود به اسلات، پاور و طراحی ورکاستیشن | سریعترین مسیر برای افزایش یا کاهش منابع |
| بازی، رندر و تولید محتوا | هدف اصلی نیست | قویترین گزینه این مقایسه | ممکن، اما تجربه تعاملی و هزینه باید سنجیده شود |
| شروع پروژه | پس از نصب و آمادهسازی محلی | نیازمند مونتاژ یا خرید ورکاستیشن | در صورت ظرفیت منطقهای، در چند دقیقه |
تفاوت معماری؛ سیستم کامل در برابر کارت گرافیک
GX10 یک Appliance رومیزی AI است. CPU بیستهستهای Arm، GPU Blackwell، حافظه 128GB، SSD، شبکه 10GbE، ConnectX-7 و DGX OS در یک بدنه کوچک ارائه میشوند. هدف آن این است که توسعهدهنده بدون طراحی یک سیستم چندقطعهای، محیط نزدیک به پشته نرمافزاری NVIDIA داشته باشد.
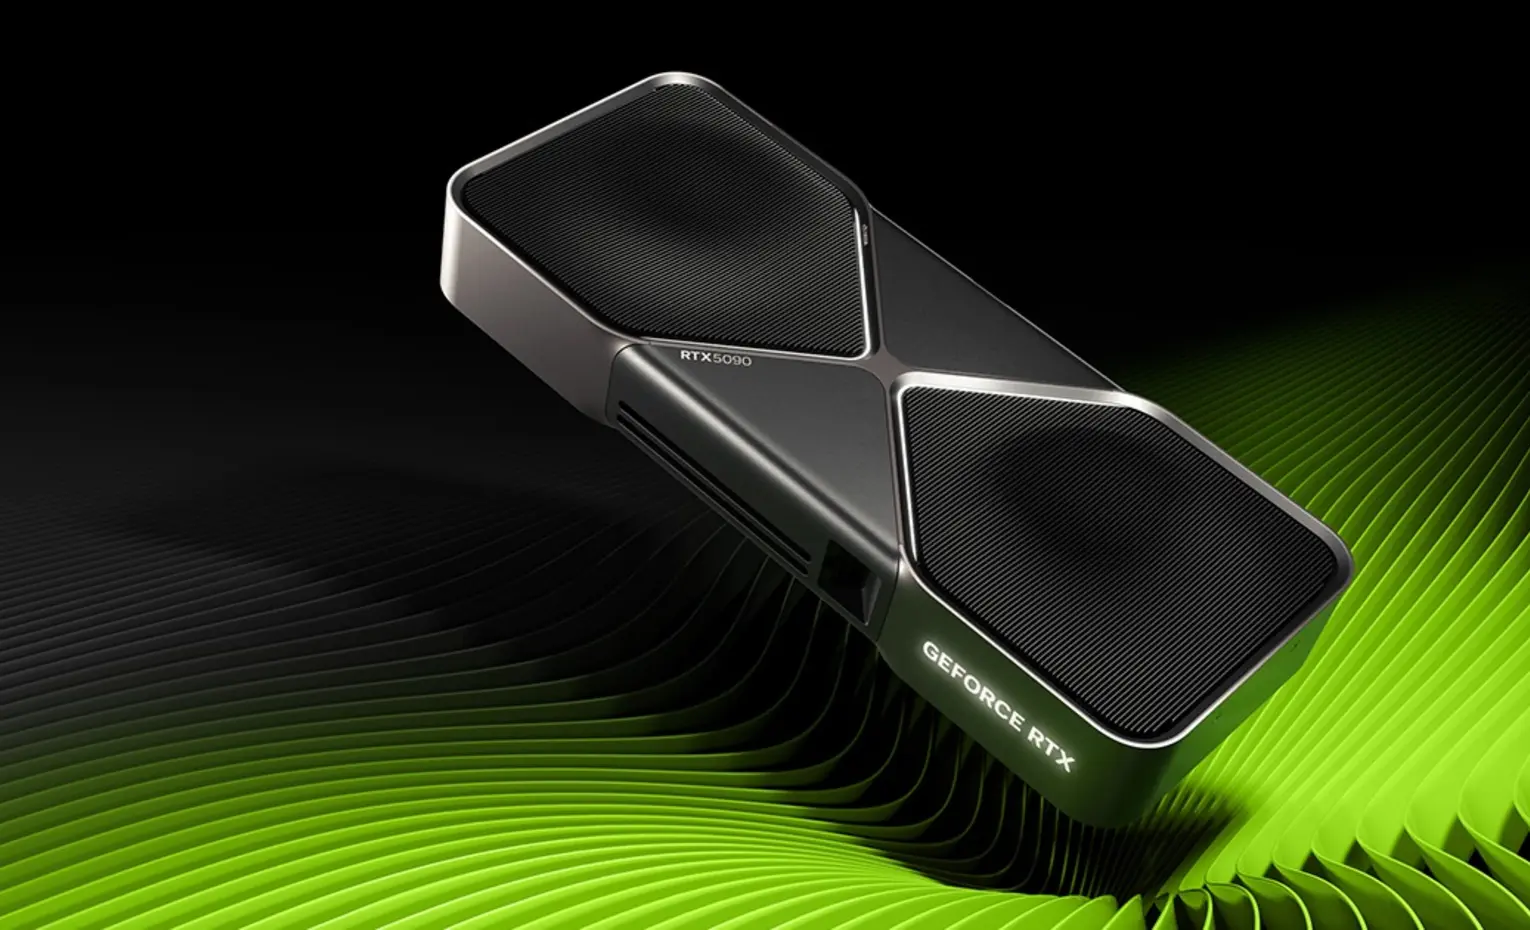
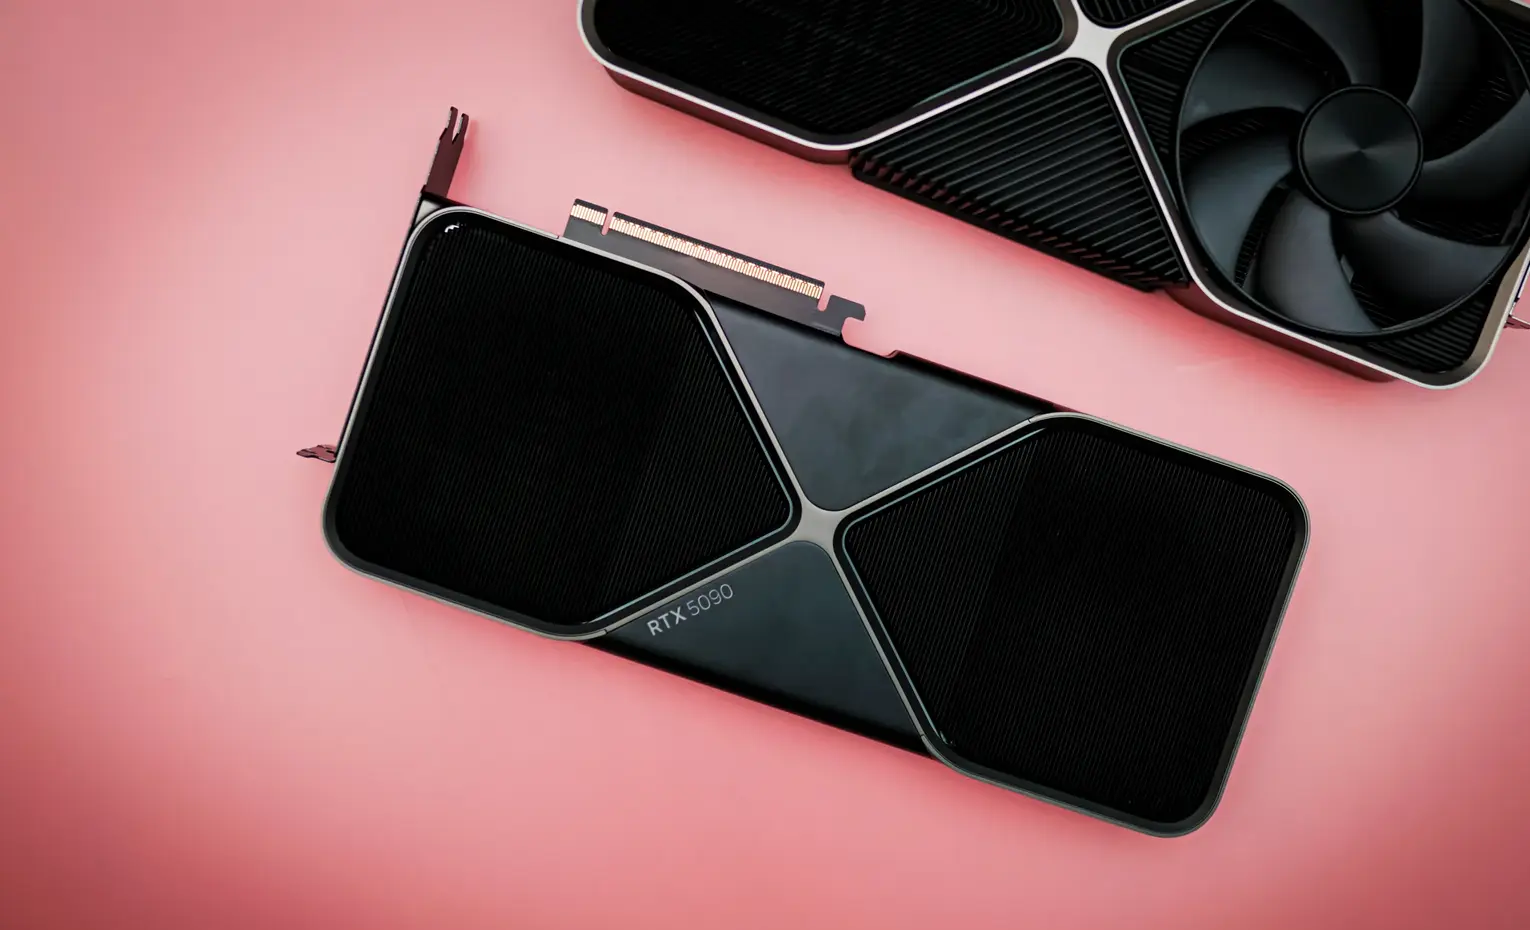
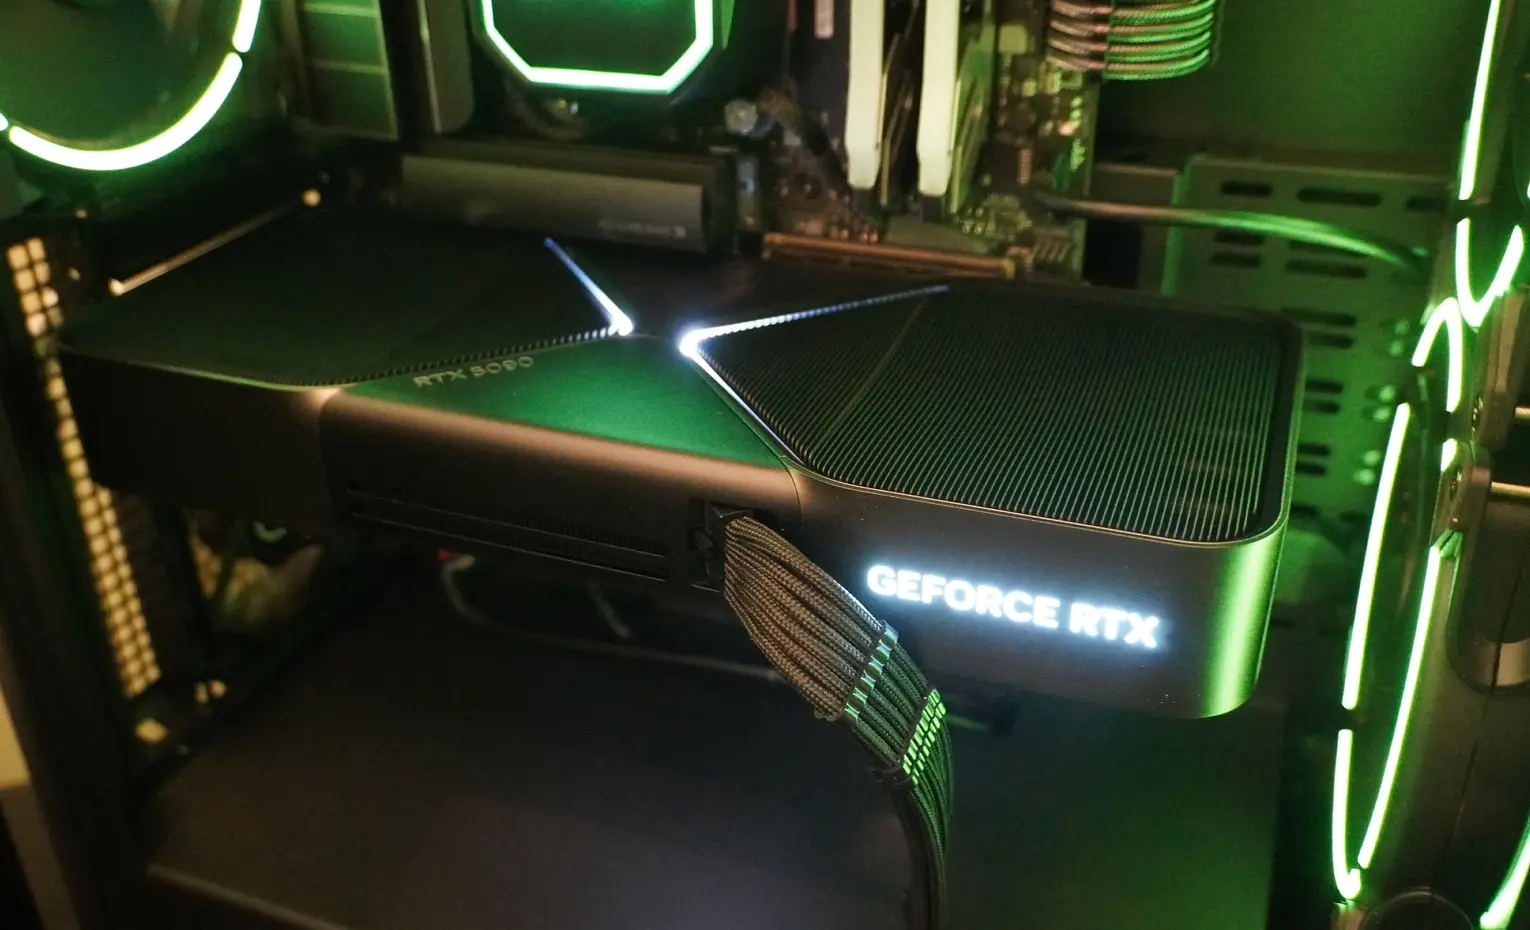
RTX 5090 یک GPU پرقدرت مصرفی/Creator است. مشخصات رسمی NVIDIA برای Founders Edition شامل 21760 هسته CUDA، 32GB حافظه GDDR7، گذرگاه 512-bit، توان گرافیکی 575 وات و پاور پیشنهادی حداقل 1000 وات برای کل سیستم است. عملکرد نهایی به CPU، رم، مادربرد، SSD، Power Limit و مدل کارت سازنده وابسته خواهد بود.
GPU ابری نیز یک قطعه مشخص نیست. میتوان یک L4، A100، H100، H200، B200 یا مجموعهای از چند GPU را برای مدت محدود اجاره کرد. به همین دلیل عبارت «Cloud سریعتر است» بدون نام Instance، تعداد GPU و شبکه معنای دقیقی ندارد.
حافظه؛ جایی که GX10 برتری روشن دارد
مزیت اصلی GX10 ظرفیت 128GB منسجم است. مدل 70B در FP16 حدود 140GB وزن خام میخواهد و روی هیچیک از این دو گزینه به همان شکل ساده جا نمیشود؛ اما ورژن 4-bit آن حدود 35GB وزن خام دارد. روی GX10 فضای کافی برای وزن، KV Cache و Runtime باقی میماند. روی RTX 5090 با 32GB VRAM، همان مدل ممکن است به Offload بخشی از وزنها به رم سیستم نیاز داشته باشد.
Offload میتواند مدل را قابل اجرا کند، اما انتقال میان VRAM و رم از مسیر PCIe معمولاً سرعت را کاهش میدهد. داشتن 128GB رم سیستم کنار RTX 5090 به معنی 160GB حافظه GPU یکپارچه نیست. این تفاوت برای LLM بزرگ تعیینکننده است.
در مقابل، GDDR7 کارت RTX 5090 پهنای باند بسیار بالایی دارد و برای مدلی که کاملاً در 32GB جا میشود میتواند سرعت جذابی ارائه کند. ظرفیت بیشتر همیشه به معنی سرعت بیشتر نیست. مقاله فریب بازاریابی هوش مصنوعی در پردازندهها همین ضرورت خواندن اعداد در Context واقعی را یادآوری میکند.
مدل 8B تا 32B؛ RTX 5090 یا GX10؟
برای مدلهای 8B، 14B و بسیاری از مدلهای 20B تا 32B با Quantization مناسب، هر دو گزینه ظرفیت کافی دارند. RTX 5090 میتواند بهدلیل توان GPU و پهنای باند حافظه بالاتر در بسیاری از Backendها سریعتر باشد، ولی این نتیجه باید با مدل و Runtime یکسان سنجیده شود.
GX10 فضای بیشتری برای Context بلند، چند مدل همزمان، Embedding، Reranker و سرویسهای RAG دارد. اگر هدف یک Agent چندبخشی است که هم LLM و هم مدل بینایی و Speech را همزمان نگه میدارد، ظرفیت یکپارچه میتواند از سرعت خام مهمتر شود.
مدل 70B و 120B؛ انتخاب به نفع GX10 تغییر میکند
در رده 70B، 32GB VRAM محدودیت محسوس است. بعضی ورژنهای 4-bit بسیار فشرده ممکن است نزدیک این ظرفیت قرار بگیرند، اما KV Cache و سربار Runtime حاشیه را کم میکند. GX10 برای Llama 3.3 70B با NVFP4 و مدلهای مشابه فضای منطقیتری دارد.
برای نمونههای 120B مانند GPT-OSS-120B با MXFP4، راهنماهای رسمی NVIDIA اجرای مدل را روی سختافزار DGX Spark/GB10 نشان میدهند. RTX 5090 تکی برای نگهداری چنین وزنی در VRAM کافی نیست و به Offload سنگین یا چند کارت نیاز دارد.
Cloud میتواند هر دو مسئله را با انتخاب GPU دارای 80GB یا مجموعه چند GPU حل کند. اگر مدل بزرگ فقط هفتهای چند ساعت برای آزمایش لازم است، اجاره ممکن است منطقیتر از خرید باشد. اگر هر روز و با داده حساس اجرا میشود، GX10 میتواند هزینه و پیچیدگی ارسال داده را کاهش دهد.
پهنای باند حافظه و سرعت Token
استنتاج LLM، بهویژه در مرحله Decode، غالباً به پهنای باند حافظه حساس است. GX10 پهنای باند رسمی 273GB/s دارد. RTX 5090 با GDDR7 و گذرگاه 512-bit پهنای باند بسیار بیشتری ارائه میکند. بنابراین اگر مدل در VRAM جا شود، RTX 5090 میتواند مزیت سرعت داشته باشد.
اما مدلی که جا نمیشود، نمیتواند از همه این پهنای باند بهره ببرد. Offload به رم سیستم و PCIe گلوگاه ایجاد میکند. مقایسه درست باید هم «سرعت مدل کوچک» و هم «قابلیت اجرای مدل بزرگ» را جدا نشان دهد.
توان برق و خنککاری
GX10 یک سیستم کامل کوچک با آداپتور تا 240 وات و ورودی دستگاه تا 180 وات است. RTX 5090 بهتنهایی 575 وات Total Graphics Power دارد و NVIDIA برای سیستم مرجع پاور 1000 وات را پیشنهاد میکند. CPU پرقدرت، رم و سایر قطعات مصرف کل ورکاستیشن را افزایش میدهند.
این تفاوت در استفاده 24 ساعته، برق اضطراری، گرما و صدای محیط اهمیت دارد. RTX 5090 برای دفع گرمای بیشتر به کیس و جریان هوای جدی نیاز دارد. GX10 تراکم بالایی دارد و خنککاری خودش نیز باید در بار طولانی بررسی شود، اما بودجه توان پایینتری دارد.
قیمت انرژی تنها بخش هزینه نیست. قطعاتی که گرمتر کار میکند میتوانند نیاز به تهویه، سرویس و UPS قویتر داشته باشید. نمونههای کلان مانند تأمین انرژی دیتاسنترهای xAI نشان میدهند انرژی در هر مقیاس بخشی از اقتصاد AI است.

Windows و نرمافزارهای عمومی؛ مزیت ورکاستیشن RTX
GX10 بر DGX OS و Arm64 تکیه دارد. بسیاری از ابزارهای مدرن AI و Containerها سازگارند، اما هر باینری x86 یا نرمافزار اختصاصی Windows روی آن اجرا نمیشود. اگر سیستم علاوه بر AI برای Adobe، نرمافزار مهندسی، رندر سهبعدی، بازی یا Driverهای تخصصی لازم است، ورکاستیشن RTX انعطاف بیشتری دارد.
RTX 5090 از Game Ready و Studio Driver پشتیبانی میکند و برای Ray Tracing، DLSS، تدوین و رندر نیز طراحی شده است. GX10 را نباید فقط بهدلیل داشتن Blackwell جایگزین کارت گرافیک گیمینگ دانست.
Linux و محیط استاندارد AI؛ مزیت GX10
GX10 با CUDA، Container Runtime، NGC و ابزارهای NVIDIA برای توسعه AI آماده میشود. یک تیم Linux میتواند Prototype را محلی بسازد و سپس Container را به زیرساخت بزرگتر منتقل کند. مسیر نرمافزاری یکپارچهتر، زمان مونتاژ و عیبیابی Driverهای یک PC سفارشی را کم میکند.
این مزیت زمانی واقعی است که Repository با Arm64 سازگار باشد. بسته Python دارای Extension باینری، Driver تجهیزات یا Library قدیمی ممکن است نیاز به Build دوباره داشته باشد. Proof of Concept پیش از خرید ضروری است.
Cloud چه زمانی برنده است؟
- آموزش یا Fine-tuning سنگین فقط چند روز در ماه انجام میشود.
- پروژه ناگهان به چند H100، H200 یا B200 نیاز دارد.
- تیم توزیعشده است و دسترسی شبکهای آماده میخواهد.
- نمیخواهید مسئول خرابی سختافزار، برق و خنککاری باشید.
- بار کاری متغیر است و میتوان منابع را هنگام بیکاری خاموش کرد.
سرویسهای رسمی Cloud قیمت را براساس Instance، منطقه، تعهد زمانی، Spot، Storage و انتقال داده محاسبه میکند. برای مثال Google Cloud هزینه GPU را جدا از CPU و RAM توضیح میدهد و AWS برای H100 نرخ Instance یا Accelerator دارد. عدد ساعتی بدون Storage و شبکه هزینه نهایی نیست.
Cloud چه زمانی گران یا پرریسک میشود؟
وقتی Instance شبانهروز روشن بماند، تیم فراموش کند منابع را خاموش کند، Dataset بزرگ مرتب منتقل شود یا IP ثابت و Storage پرسرعت اضافه شود، هزینه بالا میرود. ظرفیت GPU نیز در همه Regionها تضمینشده نیست و ممکن است Reservation لازم باشد.
داده حساس چالش دیگری است. Cloud میتواند بسیار امن باشد، اما تنظیم IAM، رمزگذاری، Log، Region و قرارداد سازمانی میخواهد. پردازش محلی مسیر داده را کوتاهتر میکند، ولی امنیت خودکار نیست. مقاله هوش مصنوعی و حفظ حریم خصوصی اهمیت تفاوت پردازش محلی و ابری را از زاویه دیگری بررسی میکند.
هزینه واقعی RTX 5090 فقط قیمت کارت نیست
برای RTX 5090 باید قیمت GPU، CPU، مادربرد، حداقل 128GB رم در بعضی Workflowها، SSD، پاور 1000 وات یا بیشتر، کیس و خنککننده را جمع کرد. در ایران، موجودی کارت و تفاوت مدلهای AIB نیز قیمت و ابعاد را تغییر میدهد.
در مقابل، GX10 سیستم کامل است اما ارتقای قطعات آن مانند PC آزاد نیست. SSD داخلی یک اسلات دارد و ASUS تعویض توسط کاربر را پشتیبانی نمیکند. هزینه NAS یا Storage خارجی ممکن است به ورژن کمظرفیت اضافه شود. تغییرات بازار حافظه که در گزارش کمبود جهانی RAM آمده، روی هر دو مسیر اثر دارد.
فرمول ساده نقطه سربهسر Cloud
برای مقایسه، هزینه کامل خرید را بر هزینه موثر هر ساعت Cloud تقسیم کنید. هزینه خرید باید شامل سختافزار، مالیات، ضمانت، UPS، برق سهساله و زمان مدیریت باشد. هزینه Cloud نیز باید GPU، CPU، RAM، Disk، Snapshot، انتقال داده و ساعات بیکار را شامل شود.
اگر هزینه کل محلی 100 واحد و Cloud ساعتی 0.05 واحد باشد، نقطه خام سربهسر 2000 ساعت است. اما ارزش نقدینگی، سرعت GPU ابری، خرابی، استهلاک و ارزش فروش دستگاه این عدد را تغییر میدهند. بنابراین یک جدول سناریویی با استفاده کم، متوسط و 24 ساعته بسازید.
مقایسه برای RAG و دستیار سازمانی
برای RAG، فقط اندازه LLM مهم نیست. Embedding، Reranker، Vector Database، Parser و Context هم منابع میخواهند. GX10 میتواند چند جزء را در حافظه 128GB نگه دارد و داده را محلی پردازش کند. RTX 5090 برای LLM کوچک سریع است، اما 32GB VRAM ممکن است تقسیم منابع میان چند مدل را سخت کند.
Cloud برای سرویس با کاربران زیاد و Autoscaling مناسبتر است. معماری ترکیبی نیز منطقی است: توسعه و داده حساس روی GX10، Peak Load یا پردازش غیرحساس روی Cloud. قراردادهای زیرساختی مانند قرارداد OpenAI با Oracle نشان میدهند حتی شرکتهای AI نیز ظرفیت را براساس مقیاس توزیع میکند.
مقایسه برای تولید تصویر و ویدئو
RTX 5090 برای Creator، Encoder/Decoder، رندر و ابزارهای Windows انتخاب طبیعیتری است. اگر مدل تصویر یا ویدئو در 32GB جا شود، توان و پهنای باند GPU اهمیت بالایی دارد. GX10 ظرفیت بیشتری برای مدل یا Pipeline چندبخشی فراهم میکند، اما هدف اصلی آن جایگزینی ورکاستیشن Creator نیست.
Cloud برای پروژههای ویدئویی انفجاری یا چند GPU مناسب است؛ میتوان چند ساعت منابع بزرگ گرفت و سپس خاموش کرد. هزینه خروج فایلهای حجیم و Storage باید از ابتدا حساب شود.
مقایسه برای Fine-tuning
Fine-tuning کامل مدل بزرگ حافظه زیادی برای Gradient و Optimizer State میخواهد. GX10 بیشتر برای روشهای کارآمد مانند LoRA و QLoRA و مدلهای تا رده اعلامشده مناسب است. RTX 5090 میتواند LoRA مدلهای کوچکتر را سریع اجرا کند، ولی VRAM سقف پروژه را محدود میکند.
برای آموزش کامل یا Experiment چند GPU، Cloud معمولاً انعطاف بیشتری دارد. سرویسهای AWS P5 با H100 و شبکه پرسرعت برای چنین بارهایی طراحی شدهاند. این سطح را با یک کارت مصرفی یا کامپیوتر رومیزی یکسان ندانید.
ریسک خرابی و تداوم کار
سختافزار محلی Single Point of Failure است. خرابی SSD، آداپتور یا دستگاه میتواند پروژه را متوقف کند. Backup، Spare و ضمانت واقعی لازماند. Cloud نیز بدون ریسک نیست؛ قطعی Region، محدودیت Quota، تغییر قیمت و قفلشدن به سرویسدهنده باید مدیریت شوند.
بهترین معماری برای پروژه حیاتی معمولاً Hybrid است: داده و اجرای روزمره محلی، Backup رمزگذاریشده و مسیر اضطراری Cloud. مقیاسهای بزرگ مانند دیتاسنترهای هوش مصنوعی Meta نیز با افزونگی و شبکه طراحی میشوند، نه یک GPU منفرد.
کدام گزینه برای چه کسی مناسبتر است؟
GX10: پژوهشگر یا تیمی که مدل 70B و بزرگتر، RAG خصوصی، مصرف روزانه و بدنه کممصرف میخواهد و Workflow او با Linux/Arm64 سازگار است.
RTX 5090: کاربری که مدلهای زیر 32GB، سرعت بالا، Windows، بازی، رندر، تدوین و ارتقای آزاد قطعات را در یک سیستم میخواهد.
GPU ابری: تیمی که بار متغیر، آموزش سنگین، چند GPU، دسترسی سریع یا همکاری از راه دور میخواهد و میتواند هزینه و امنیت Cloud را مدیریت کند.
چکلیست انتخاب نهایی
- حجم واقعی فایل وزن و Quantization مدل را ثبت کنید.
- Context، Batch و تعداد کاربر همزمان را مشخص کنید.
- سازگاری Arm64، x86 و Windows را بررسی کنید.
- برای RTX 5090 قیمت کل سیستم را حساب کنید، نه فقط کارت.
- برای GX10 ظرفیت SSD و هزینه NAS را اضافه کنید.
- برای Cloud هزینه Storage، انتقال داده و Idle را وارد کنید.
- مصرف برق و UPS سهساله را برآورد کنید.
- Benchmark یکسان روی مدل واقعی بگیرید.
- حریم خصوصی و محل پردازش داده را مستند کنید.
- مسیر Backup و خرابی را پیش از خرید طراحی کنید.
برای دنبالکردن سختافزارهای جدید AI، مطلب پردازندههای AMD برای گیمینگ و هوش مصنوعی نیز دید مکملی درباره تفاوت PC عمومی و سیستم تخصصی میدهد.
سوالهای متداول
آیا GX10 از RTX 5090 سریعتر است؟
نه بهطور مطلق. برای مدل کوچک که در 32GB جا میشود، RTX 5090 میتواند سریعتر باشد. برای مدل بزرگتر، ظرفیت 128GB GX10 ممکن است اصلاً امکان اجرا را فراهم کند.
آیا 128GB رم سیستم کنار RTX 5090 همان حافظه GX10 است؟
خیر. رم سیستم و 32GB VRAM کارت جدا هستند و Offload از PCIe عبور میکند. GX10 حافظه منسجم مشترک CPU و GPU دارد.
آیا Cloud همیشه ارزانتر است؟
برای استفاده کوتاه یا متغیر اغلب جذاب است؛ برای بار ثابت و طولانی ممکن است هزینه تجمعی از خرید محلی بیشتر شود. محاسبه باید همه هزینهها را دربرگیرد.
برای Llama 70B کدام بهتر است؟
GX10 با Quantization مناسب مسیر سادهتری دارد. RTX 5090 تکی ممکن است به Offload نیاز داشته باشد. Cloud با GPU حافظهبالا سریعتر و گرانتر میتواند گزینه سوم باشد.
پیشنهاد مطالعه
برای زمینه بیشتر، مقاله GB10 Grace Blackwell، تحلیل اعداد بازاریابی AI و آرشیو هوش مصنوعی تهران اسپیکر را ببینید. مطالب زیرساخت و سختافزار در بخش تکنولوژی دنبال میشوند.
کلام آخر
در مقایسه ASUS Ascent GX10 با RTX 5090 و GPU ابری، GX10 برای ظرفیت حافظه و اجرای محلی مدل بزرگ، RTX 5090 برای سرعت مدلهای کوچکتر و کاربری ترکیبی Creator/Windows و Cloud برای مقیاسپذیری و آموزش مقطعی برتری دارد.
اگر مدل اصلی شما 70B یا بزرگتر است و هر روز با داده خصوصی اجرا میشود، GX10 ارزش بررسی جدی دارد. اگر بیشتر مدلها در 32GB جا میشوند و سیستم باید رندر، ویدئو و بازی را نیز انجام دهد، RTX 5090 منطقیتر است. اگر بار پروژه نامنظم یا نیازمند چند GPU است، Cloud را با هزینه کامل ساعتی مقایسه کنید.
بهترین انتخاب را Benchmark واقعی تعیین میکند: همان مدل، همان Context، همان تعداد کاربر و هزینه سهساله. هر مقایسهای که این چهار مورد را حذف کند، فقط مشخصات روی کاغذ را کنار هم گذاشته است.


پاسخگوی سوالات شما هستیم
دیدگاهی وجود ندارد!