


آنچه خواهید خواند
- از Notebook تا سرویس Production چه فاصلهای وجود دارد؟
- vLLM، NVIDIA NIM یا llama.cpp؛ کدام مسیر مناسبتر است؟
- قبل از Runtime، Workload را تعریف کنید
- انتخاب مدل و Quantization
- سازگاری ARM64 را پیش از دانلود مدل بررسی کنید
- معماری پیشنهادی تکگرهای روی GX10
- OpenAI-compatible API دقیقاً چه معنایی دارد؟
- Chat Template و System Prompt
- KV Cache چگونه ظرفیت همزمانی را تعیین میکند؟
- Continuous Batching و Chunked Prefill
- سه معیار اصلی Latency را جدا ببینید
- Benchmark ظرفیت GX10 را چگونه طراحی کنیم؟
- Prefix Caching چه زمانی مفید است؟
- صف، اولویت و Fairness
- Structured Output و Tool Calling
- اتصال سرور مدل به RAG
- سرویسدهی Adapterهای LoRA
- امنیت API مدل زبانی
- Monitoring و Alerting
- پایداری، Health Check و Restart
- استقرار Air-gapped و Cache مدل
- دو GX10 برای Serving چه تغییری ایجاد میکند؟
- GX10، Cloud یا معماری ترکیبی؟
- پایلوت 30 روزه سرور مدل
- خطاهای رایج در راهاندازی سرور مدل
- چکلیست قبل از تحویل به کاربر
- پرسشهای متداول
- کلام آخر
راه اندازی سرور مدل زبانی روی ASUS Ascent GX10 چگونه انجام میشود؟
راه اندازی سرور مدل زبانی روی ASUS Ascent GX10 یعنی یک مدل سازگار را با موتور Inference مانند vLLM یا NVIDIA NIM بارگذاری کنیم، آن را پشت API کنترلشده قرار دهیم و ظرفیت، صف، امنیت و مانیتورینگ را برای مصرف واقعی تنظیم کنیم. اجرای موفق یک Prompt در ترمینال فقط Proof of Concept است؛ سرویس سازمانی به Authentication، Rate Limit، Timeout، Health Check، ثبت Metric و مسیر بازگشت نیاز دارد.
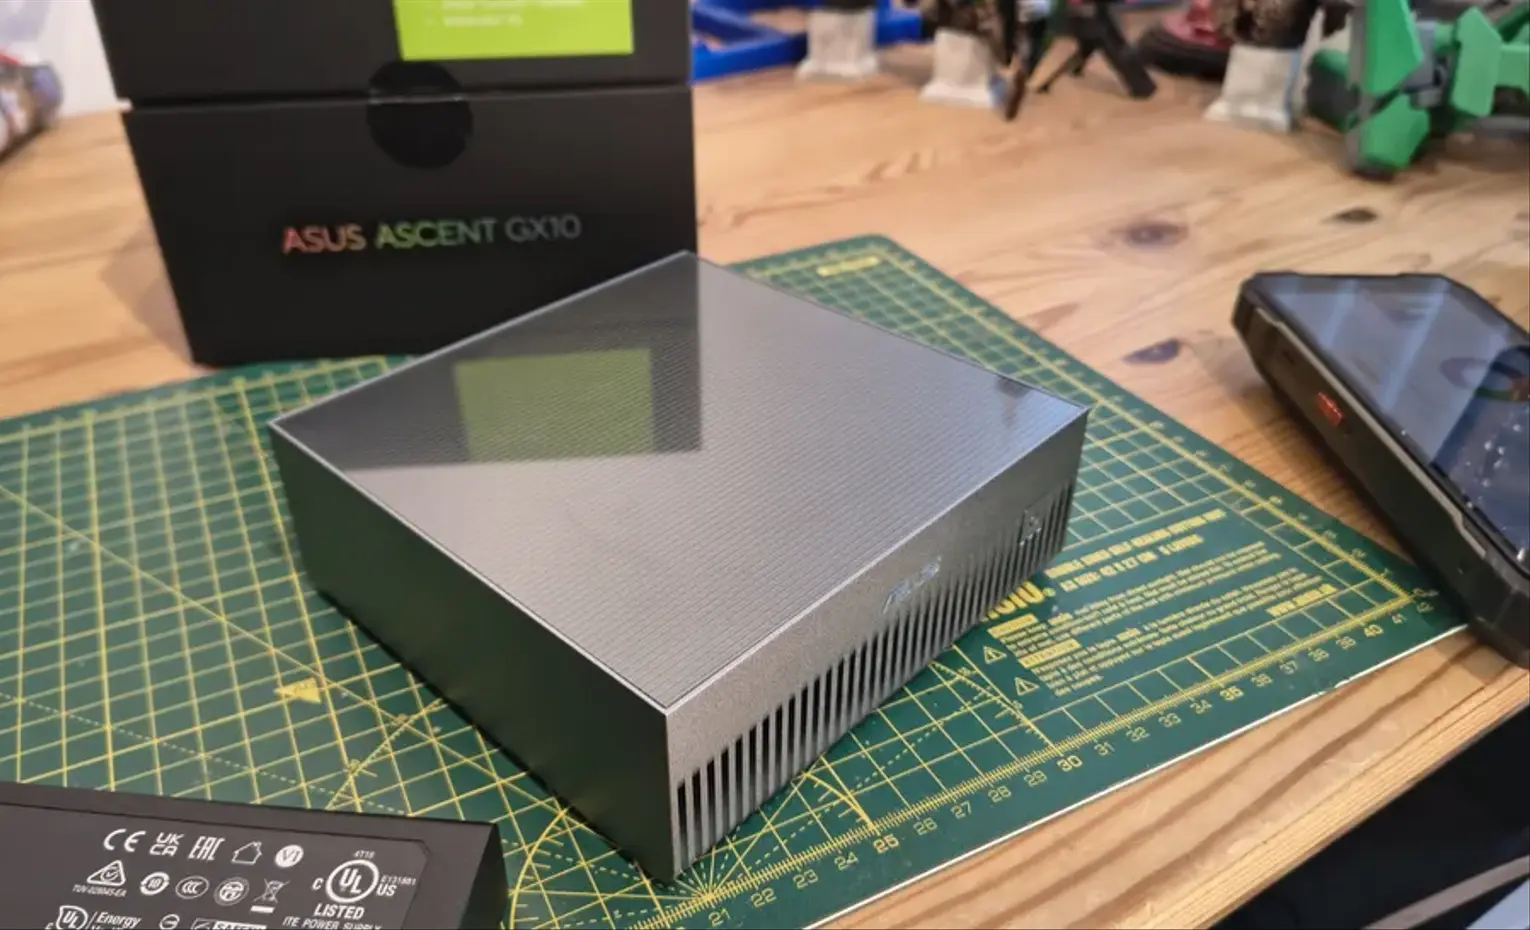
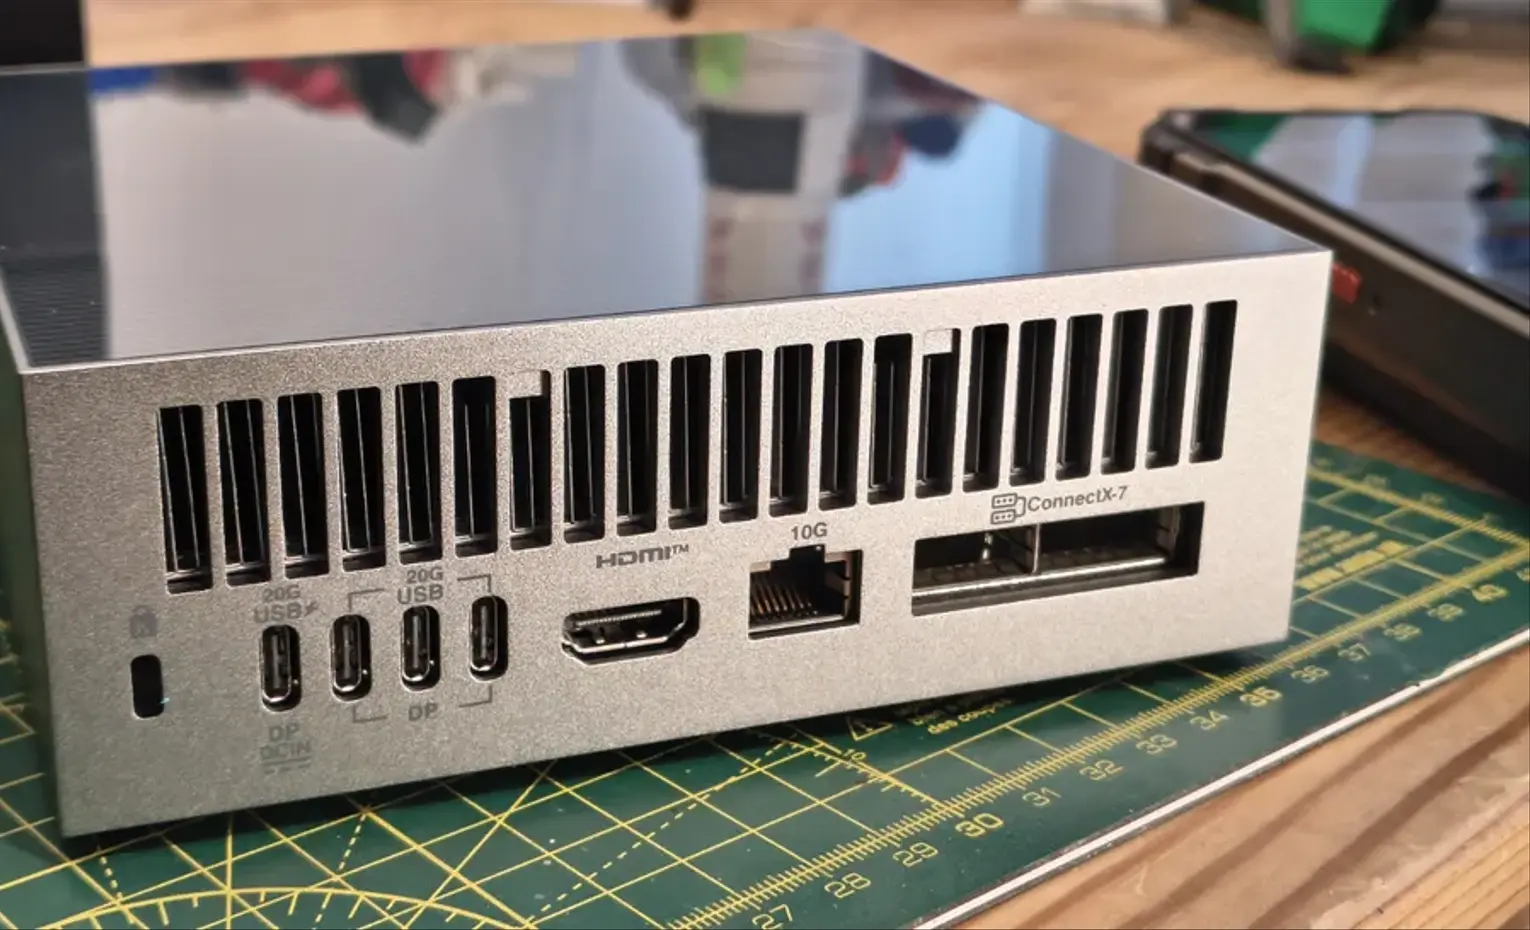
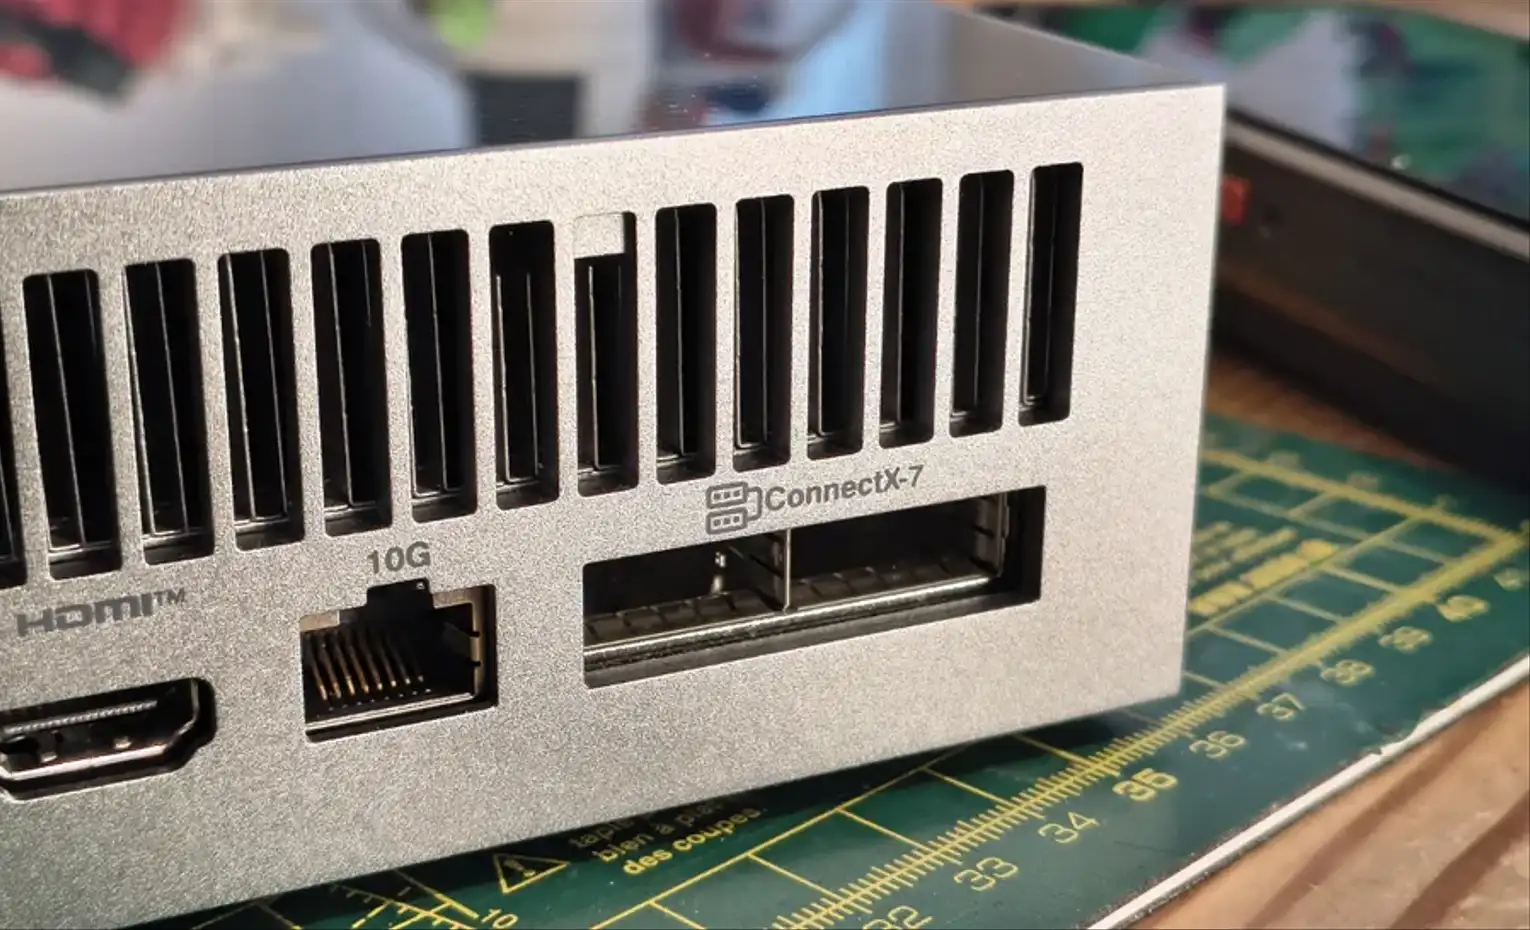
ورک استیشن هوش مصنوعی ایسوس مدل Ascent GX10 به پردازنده NVIDIA GB10 Grace Blackwell، حافظه یکپارچه 128GB LPDDR5x، Ubuntu Linux، شبکه 10GbE و ConnectX-7 مجهز است. این ترکیب برای سرویسدهی محلی مدلهای زبانی بزرگ طراحی جذابی دارد، اما تعداد کاربر همزمان و سرعت تولید به مدل، Quantization، طول Context، Batch و الگوی درخواست بستگی دارد. برای شناخت دستگاه ابتدا بررسی سوپر کامپیوتر ASUS Ascent GX10 و توضیح پردازنده GB10 Grace Blackwell را ببینید.
در این راهنما هدف انتخاب یک نام مشهور نیست. ابتدا Workload تعریف میشود، سپس مدل و Runtime انتخاب میشوند و در پایان با Benchmark واقعی تصمیم میگیریم که GX10 برای چت داخلی، RAG، Agent یا استخراج ساختاری چه ظرفیتی دارد. هیچ عدد عمومی «کاربر همزمان» برای همه مدلها معتبر نیست.
از Notebook تا سرویس Production چه فاصلهای وجود دارد؟
در Notebook معمولاً یک کاربر، یک مدل و چند Prompt کنترلشده وجود دارد. Production با درخواستهای کوتاه و بلند، قطع اتصال، ورودی نامعتبر، ترافیک ناگهانی و چند مصرفکنده روبهرو است. اگر همه درخواستها مستقیم به موتور مدل برسند، یک Prompt بسیار بلند میتواند حافظه KV Cache را اشغال و تأخیر دیگران را افزایش دهد.
| لایه | وظیفه | اگر حذف شود |
|---|---|---|
| Client SDK | ساخت درخواست و مدیریت Streaming | رفتار ناسازگار بین برنامهها |
| API Gateway | هویت، Rate Limit و ثبت درخواست | دسترسی مستقیم و بدون کنترل |
| Queue و Scheduler | اولویت و Backpressure | ازدحام و Out of Memory |
| Inference Runtime | Batching، KV Cache و Decode | عدم استفاده مؤثر از سختافزار |
| Model Store | وزن، Tokenizer و ورژن | راهاندازی غیرقابل پخش |
| Observability | Latency، Throughput و خطا | بهینهسازی بر اساس حدس |
| Policy Layer | مجوز Tool و پالایش داده | ریسک امنیتی و عملیاتی |
Production یعنی پاسخ قابل پیشبینی زیر بار مشخص، نه صرفاً سریعترین Demo. SLA باید بگوید چه درصدی از درخواستها در چه زمانی اولین Token را میگیرند، طول خروجی چقدر است و هنگام پرشدن ظرفیت چه پاسخی برمیگردد.
vLLM، NVIDIA NIM یا llama.cpp؛ کدام مسیر مناسبتر است؟
| گزینه | مزیت اصلی | مناسب برای | نکته تصمیم |
|---|---|---|---|
| vLLM | OpenAI-compatible API، Continuous Batching و کنترل گسترده | تیم فنی و مدلهای Hugging Face | ورژن و سازگاری مدل باید سنجیده شود |
| NVIDIA NIM | Container و Profile آماده اکوسیستم NVIDIA | استقرار استانداردشده و پشتیبانیپذیر | Support Matrix و شرایط دسترسی بررسی شود |
| llama.cpp | سادگی و اکوسیستم GGUF | آزمایش محلی و مدل Quantized | اهداف Throughput با vLLM یکسان نیست |
| Transformers Server سفارشی | انعطاف کامل کد | پژوهش یا منطق خاص | بخش زیادی از Serving باید ساخته شود |
vLLM برای سرویسدهی پرترافیک طراحی شده و درخواستها را به شکل پیوسته Batch میکند. API سازگار با OpenAI انتقال Clientهای موجود را آسانتر میکند، ولی «سازگار» به معنی یکسانبودن همه پارامترها و رفتارها نیست. قابلیتهایی مانند Tool Calling، Structured Output و Logprobs باید جدا آزمایش شوند.
NIM Container، مدیریت Cache و Profileهای بهینه را در اکوسیستم NVIDIA فراهم میکند. مدل و سختافزار باید در Support Matrix همان ورژن قرار داشته باشید. وجود Image نیز مجوز استفاده از مدل یا دسترسی رایگان به همه Artifactها را تضمین نمیکند.
llama.cpp برای مدلهای GGUF و راهاندازی سبک ارزشمند است. اگر هدف چند کاربر، Contextهای بلند و Throughput بالاست، باید در همان Benchmark با گزینه دیگر مقایسه شود. انتخاب Runtime بر اساس شهرت، بدون سنجش الگوی ترافیک، تصمیم فنی قابل دفاعی نیست.
قبل از Runtime، Workload را تعریف کنید
عبارت «چتبات سازمانی» برای ظرفیتسنجی کافی نیست. باید طول متوسط و P95 ورودی، طول خروجی، نرخ درخواست، تعداد نشست فعال، نیاز Streaming و هدف Latency مشخص شود. یک سامانه خلاصهسازی سند با Prompt دههزار Token با دستیار پاسخ کوتاه رفتار متفاوتی دارد.
Request Mix را بنویسید: چند درصد چت، چند درصد RAG، چند درصد استخراج JSON و چند درصد Agent است؟ Tool Call معمولاً چند دور رفتوبرگشت دارد و هر دور Context را بزرگتر میکند. اگر فقط یک درخواست منفرد Benchmark شود، ظرفیت واقعی Agent پنهان میماند.
کیفیت نیز Constraint است. مدل کوچک Quantized ممکن است سریع باشد ولی در فارسی یا وظیفه تخصصی خطای بیشتری بدهد. مدل بزرگتر شاید کیفیت بالاتر اما همزمانی کمتر داشته باشد. مقاله آشنایی با اکوسیستم Mistral AI نمونهای از تنوع مدلهاست؛ ورژن نهایی باید با Model Card و Test خود سازمان انتخاب شود.
انتخاب مدل و Quantization
مدل Instruct یا Chat معمولاً برای API مکالمه مناسبتر از Base Model است، زیرا الگوی دستور و نقشها را دیده است. ورژن Base برای Continued Training یا پژوهش مفید است، اما ممکن است بدون Fine-tuning پاسخ مکالمهای قابل اتکا ندهد.
Quantization اندازه وزن و مصرف حافظه را کاهش میدهد و فضای بیشتری برای KV Cache میگذارد. FP8، NVFP4، AWQ، GPTQ و GGUF مسیرهای متفاوتاند و همه روی هر Runtime یا معماری به یک شکل پشتیبانی نمیشوند. کیفیت و سرعت Artifact Quantized باید با ورژن مرجع مقایسه شود.
مدلی که در حافظه Load میشود لزوماً ظرفیت سرویس خوبی ندارد. اگر وزن تقریباً همه حافظه را بگیرد، KV Cache برای Context و همزمانی محدود میشود. حاشیه سیستمعامل، Compile Workspace و Runtime نیز لازم است.
توان اسمی سختافزار معیار مستقیمی برای Token/sec نیست. Attention، نوع Precision، Kernel و طول Prompt اثر زیادی دارند. همان هشداری که در مقاله بازاریابی AI در پردازندهها مطرح شده، اینجا هم کاربرد دارد: عدد را باید در Workload خودتان تفسیر کنید.
سازگاری ARM64 را پیش از دانلود مدل بررسی کنید
GX10 از CPU معماری ARM استفاده میکند. Container، Wheel پایتون، CUDA Extension، Tokenizer و کتابخانه Quantization باید ورژن ARM64 داشته باشید. یک راهنمای x86 ممکن است روی سیستم بدون تغییر اجرا نشود.
NVIDIA برای DGX Spark مبتنی بر GB10 Playbook رسمی vLLM ارائه کرده است و این نشانه مهمی از مسیر نرمافزاری پلتفرم است. بااینحال، Image Tag، Driver، Firmware و مدل پیشنهادی باید با GX10 شما تطبیق داده شوند. «latest» انتخاب پخشپذیری نیست.
یک Smoke Test کامل اجرا کنید: Container بالا بیاید، مدل از Cache خوانده شود، Endpoint سلامت پاسخ دهد، Chat Completion و Streaming کار کند و Restart دوباره مدل را بدون دانلود غیرضروری Load کند. سپس ورژنها Freeze شوند.
معماری پیشنهادی تکگرهای روی GX10
برای شروع، یک Runtime مدل روی GX10 و یک Reverse Proxy در همان شبکه کافی است. Clientها مستقیم به Port موتور وصل نمیشوند. Proxy هویت، TLS، محدودیت اندازه Body، Rate Limit، Timeout و Audit را اعمال میکند و فقط Endpointهای لازم را منتشر میسازد.
Model Cache روی Volume پایدار قرار میگیرد تا Restart باعث دانلود دوباره نشود. Config در فایل ورژندار و Secretها خارج از آن نگهداری میشوند. Log متن کامل Prompt بهطور پیشفرض خاموش یا Redact میشود، زیرا Prompt ممکن است داده شخصی یا محرمانه داشته باشد.
Queue باید ظرفیت محدود داشته باشد. وقتی صف پر است، پاسخ 429 یا 503 با Retry-After بهتر از پذیرش بینهایت درخواست است. Backpressure اجازه میدهد برنامه بالادستی تصمیم بگیرد منتظر بماند، درخواست را سبکتر کند یا مسیر جایگزین داشته باشد.
پردازش محلی مرز داده را کوچکتر میکند، اما خودبهخود امن نیست. مطلب محدودیتهای هوش مصنوعی محلی نشان میدهد محل اجرا تنها بخشی از مسئله است؛ Patch، دسترسی، Backup و مانیتورینگ همچنان لازماند.
OpenAI-compatible API دقیقاً چه معنایی دارد؟
سازگاری API معمولاً یعنی Client میتواند با تغییر Base URL از مسیرهایی مانند Chat Completions استفاده کند. اما مدلهای محلی نام پارامتر، Tokenizer، Chat Template و قابلیتهای متفاوت دارند. حتی اگر JSON درخواست پذیرفته شود، نتیجه Tool Calling یا Structured Output ممکن است یکسان نباشد.
یک Contract Test بسازید که Model List، Chat، Streaming، Stop، Max Tokens، Temperature، Error Response و Cancellation را بررسی کند. Client باید پاسخ نامعتبر، Timeout و قطع Stream را مدیریت کند. اتکا به یک Prompt موفق کافی نیست.
API Key داخلی vLLM تنها برخی Prefixهای Endpoint را محافظت میکند و مستندات رسمی هشدار میدهند که همه مسیرها تحت این Authentication نیستند. بنابراین vLLM نباید با Port باز مستقیماً در اینترنت قرار گیرد. Reverse Proxy و Firewall باید مسیرهای منتشرشده را Allowlist کند.
Chat Template و System Prompt
Chat Template پیامهای System، User و Assistant را به Tokenهای مورد انتظار مدل تبدیل میکند. Template اشتباه میتواند باعث تکرار سؤال، نادیدهگرفتن نقش System یا پایاننیافتن خروجی شود. ورژن Tokenizer و Template باید همراه مدل ثبت شوند.
System Prompt را کوتاه، روشن و ورژندار نگه دارید. قراردادن صدها قانون متناقض هم زمان Prefill را بالا میبرد و هم رفتار را شکنده میکند. Policyهای قطعی مانند دسترسی کاربر یا مجوز Tool باید بیرون از مدل اعمال شوند.
برای چند کاربرد، Prompt Templateهای جدا بسازید و با شناسه ارسال کنید. Client نباید بتواند آزادانه System Prompt حساس را بازنویسی کند. تغییر Template نیز مثل تغییر کد به Regression Test نیاز دارد.
KV Cache چگونه ظرفیت همزمانی را تعیین میکند؟
در تولید خودرگرسیو، Runtime برای Tokenهای قبلی کلید و مقدار Attention را در KV Cache نگه میدارد. هرچه Context، تعداد Sequence و مدل بزرگتر باشد، حافظه Cache بیشتر میشود. وزن مدل ثابت است، اما KV Cache با بار جاری تغییر میکند.
اگر Cache کافی نباشد، Runtime ممکن است درخواست را Preempt و بخشی را دوباره محاسبه کند؛ این اتفاق Latency را افزایش میدهد. کاهش Max Context، Max Sequences یا Tokens Batched میتواند حافظه را آزاد کند، ولی روی ظرفیت و تجربه کاربر اثر دارد.
حد Context اعلامشده مدل نباید بدون محدودیت به همه کاربران داده شود. یک Prompt بسیار بلند میتواند سهم بزرگی از Cache را بگیرد. سقف جدا برای هر Endpoint و Tier کاربر تعیین کنید و قبل از Queue تعداد Token ورودی را بسنجید.
حافظه یکپارچه 128GB GX10 انعطاف بیشتری میدهد، اما بین وزن، Cache و سیستم مشترک است. ظرفیت واقعی فقط پس از اجرای مدل نهایی با Context و همزمانی واقعی مشخص میشود.
Continuous Batching و Chunked Prefill
Batching سنتی منتظر جمعشدن گروهی از درخواستها میماند. Continuous Batching میتواند Sequence تازه را هنگام اجرای دیگر درخواستها وارد Scheduler کند و استفاده از محاسبات را بهتر سازد. نتیجه به توزیع طول ورودی و خروجی وابسته است.
Prefill مرحله خواندن Prompt و Decode مرحله تولید Tokenهای بعدی است. Prompt بلند Prefill سنگینی دارد و میتواند درخواستهای در حال Decode را کند کند. Chunked Prefill ورودی بلند را به بخشها تقسیم و با Decodeها زمانبندی میکند.
تنظیم Max Batched Tokens یک معامله است. مقدار پایین ممکن است فاصله Tokenهای خروجی را بهتر کند و مقدار بالاتر Throughput یا TTFT را در برخی بارها تغییر دهد. مقدار مناسب با Sweep کنترلشده پیدا میشود، نه با کپی Config اینترنتی.
سه معیار اصلی Latency را جدا ببینید
| معیار | معنا | برای چه کسی مهم است؟ |
|---|---|---|
| TTFT | زمان تا اولین Token | کاربر چت و جستجو |
| ITL یا TPOT | فاصله میان Tokenهای خروجی | روانی Streaming |
| End-to-end Latency | زمان کامل درخواست | Workflow و Batch Job |
| Throughput | Token یا درخواست در واحد زمان | ظرفیت کل سرویس |
| Queue Time | زمان انتظار پیش از اجرا | اثر ازدحام |
میانگین کافی نیست. P50 رفتار معمول، P95 شرایط شلوغ و P99 دم بلند را نشان میدهد. یک سیستم با میانگین خوب اما P99 بسیار بد میتواند برای کاربر تعاملی آزاردهنده باشد.
Streaming TTFT را قابل مشاهده میکند، اما کل زمان محاسبه را کاهش نمیدهد. Client باید اتصال قطعشده را Cancel کند؛ در غیر این صورت مدل ممکن است خروجی بلااستفاده را تا پایان تولید کند و ظرفیت را اشغال نگه دارد.
Benchmark ظرفیت GX10 را چگونه طراحی کنیم؟
ابتدا مدل، Revision، Precision، Runtime و Config را ثابت کنید. سپس Dataset بار با Promptهای واقعی و بدون داده شخصی بسازید. طول ورودی و خروجی باید توزیع Production را بازتاب دهد؛ تکرار یک Prompt کوتاه نتیجه خوشبینانه میسازد.
Concurrency را پلهای بالا ببرید: 1، 2، 4، 8 و بیشتر تا زمانی که SLA شکسته یا خطا ظاهر شود. در هر پله TTFT، ITL، Throughput، Queue، Peak Memory، Preemption و Error Rate ثبت شوند. Warm-up از Run اصلی جدا باشد.
Open-loop Test با نرخ ثابت درخواست و Closed-loop Test با تعداد کاربر مجازی دو سؤال متفاوت را پاسخ میدهند. اولی تحمل Arrival Rate را میسنجد؛ دومی تجربه کاربران منتظر پاسخ را. هر دو برای برنامهریزی ظرفیت مفیدند.
Soak Test چندساعته یا چندروزه Memory Leak، رشد Cache، خرابی اتصال و افت تدریجی را آشکار میکند. Restart کنترلشده، پرشدن دیسک Cache و قطع Client نیز باید آزمایش شوند.
Prefix Caching چه زمانی مفید است؟
اگر درخواستها Prefix مشترک طولانی مانند System Prompt یا سند ثابت دارند، Prefix Caching میتواند محاسبات تکراری را ذخیره کند. این بهبود بیشتر Prefill را هدف میگیرد و اثر آن به میزان اشتراک واقعی Prefix وابسته است.
Cache باید مرز Tenant را رعایت کند. Hash و جداسازی اشتباه در محیط چندمستاجری میتواند ریسک نشت یا برخورد ایجاد کند. Runtime و الگوریتم Hash باید بر اساس حساسیت داده انتخاب شوند، نه فقط سرعت.
اگر هر Prompt کاملاً متفاوت است، Prefix Caching سود محدودی دارد و حافظهای که مصرف میکند باید سنجیده شود. Hit Rate، حافظه و تغییر TTFT را در Metricها ثبت کنید.
صف، اولویت و Fairness
همه درخواستها ارزش یکسان ندارند. چت کاربر، پردازش Batch شبانه و Agent چندمرحلهای باید Queue یا اولویت متفاوت داشته باشید. Batch Job نباید ظرفیت تعاملی را در ساعات کاری مصرف کند.
Fairness از اشغال سرویس توسط یک کاربر جلوگیری میکند. Rate Limit فقط تعداد درخواست نیست؛ مجموع Token ورودی و خروجی نیز اهمیت دارد. دو درخواست با اندازه ده و دههزار Token هزینه یکسانی ندارند.
Deadline-aware Scheduling میتواند درخواست دیرشده را رد یا سبکتر کند. پذیرش همه کارها و تحویل بسیار دیرهنگام معمولاً بدتر از خطای شفاف است. Client باید Fallback مشخص داشته باشد.
Structured Output و Tool Calling
خروجی JSON برای اتصال مدل به نرمافزار مفید است، اما JSON معتبر الزاماً داده درست نیست. Schema باید نوع، فیلد الزامی، Enum و محدودیت طول را تعریف کند و مقدارها پس از تولید با قواعد دامنه اعتبارسنجی شوند.
Tool Calling یک پیشنهاد مدل است، نه مجوز اجرا. Orchestrator نام Tool و Argument را Allowlist میکند، هویت کاربر را میسنجد و عملیات حساس را به تأیید میفرستد. مدل نباید Credential واقعی را در Prompt ببیند.
Agent چندمرحلهای تعداد Call و Context را افزایش میدهد. مقاله ابزارهای ساخت Agent زمینه این معماری را توضیح میدهد. در Benchmark باید یک Task کامل Agent اندازهگیری شود، نه فقط یک پاسخ مدل.
اتصال سرور مدل به RAG
در RAG، Retriever ابتدا Chunkهای مجاز را پیدا و سپس مدل بر اساس آنها پاسخ میدهد. زمان End-to-end شامل Embedding، جستجو، Rerank، ساخت Prompt و Generation است. بهینهسازی فقط Runtime مدل ممکن است گلوگاه واقعی را لمس نکند.
تعداد Chunk و طول آنها روی کیفیت و KV Cache اثر دارند. افزودن همه نتایج به Prompt هم هزینه را بالا میبرد و هم شواهد متناقض وارد میکند. Retrieval Quality باید جدا از Generation سنجیده شود.
ابزارهای منبعمحور مانند NotebookLM نشان میدهند تجربه کاربر فقط به مدل بستگی ندارد؛ مطلب بهبودهای NotebookLM نمونهای از اهمیت مدیریت منبع است. در سامانه داخلی، Citation باید به سند و سطح دسترسی معتبر متصل بماند.
سرویسدهی Adapterهای LoRA
یک مدل پایه میتواند با Adapterهای جدا برای وظایف مختلف استفاده شود. Runtime باید Mapping نام Adapter به ورژن، Base Model و مجوز مصرفکنده را بداند. درخواست کاربر نباید بتواند مسیر دلخواه فایل Adapter را Load کند.
Load پویا حافظه و Cache مدیریتی میخواهد. تعداد Adapter همزمان، زمان Swap و رفتار هنگام Cache Full باید آزمایش شود. Adapter جدید ابتدا Canary میشود و امکان بازگشت به ورژن قبلی دارد.
Merge کردن Adapter استقرار را ساده میکند، اما Artifact کامل تازه میسازد و باید دوباره Quantization و Regression Test شود. کیفیت ورژن Mergeشده از روی ورژن جدا فرض نمیشود.
امنیت API مدل زبانی
سرور مدل نباید مستقیم روی اینترنت عمومی قرار گیرد. شبکه خصوصی، Firewall، TLS، Reverse Proxy و هویت سازمانی حداقل لایهها هستند. API Key ثابت داخل Frontend مرورگر قابل حفاظت نیست و باید از Backend کنترلشده استفاده شود.
Prompt و Output میتوانند داده حساس داشته باشید. Log کامل فقط با مجوز، Retention کوتاه و Redaction ثبت شود. برای عیبیابی میتوان Metadata مانند Token Count، Latency، Model Version و Error Code را بدون متن ذخیره کرد.
محدودیت اندازه Body، Context و Output جلوی مصرف بیرویه را میگیرد. Upload فایل نیز باید در سرویس جدا با بررسی نوع، حجم و بدافزار انجام شود. مدل Parser امن فایل نیست.
راهنمای امنیت اپلیکیشنها در اندروید و آیفون اهمیت مجوز و حداقل دسترسی را در سطح Client توضیح میدهد؛ همان اصل Least Privilege باید در Gateway، Tool و Model Store رعایت شود.
Monitoring و Alerting
vLLM Metricهای Production را از Endpoint سازگار با Prometheus ارائه میکند. Request Count، Prompt Token، Generation Token، TTFT، ITL، Queue، KV Cache Usage، Preemption و Error باید در Dashboard دیده شوند.
Metric فنی را به Metric محصول متصل کنید. پاسخ سریع ولی نامعتبر موفقیت نیست. نرخ JSON معتبر، Citation صحیح، Tool Failure، لغو کاربر و Escalation انسانی نیز ثبت شوند.
Alert باید قابل اقدام باشد. افزایش Queue همراه با Utilization بالا ممکن است ظرفیت ناکافی باشد؛ Queue بالا با Utilization پایین میتواند مشکل Scheduler یا I/O باشد. یک Threshold منفرد بدون Context هشدارهای بیفایده میسازد.
Log Version ضروری است. هر Request باید Model ID، Runtime Version، Config Hash و Prompt Template Version داشته باشد تا Regression قابل ردیابی باشد.
پایداری، Health Check و Restart
Liveness فقط زندهبودن Process را میسنجد؛ Readiness باید نشان دهد مدل Load شده و Endpoint آماده پذیرش درخواست است. در زمان دانلود یا Compile، ارسال ترافیک واقعی باعث خطا میشود.
Graceful Shutdown باید پذیرش درخواست تازه را متوقف و کارهای جاری را تا Deadline تمام کند. Kill ناگهانی Streamها تجربه Client را خراب میکند. پس از Restart نیز Cache مدل باید پایدار باشد تا زمان راهاندازی قابل پیشبینی بماند.
Watchdog میتواند Process خراب را بازگرداند، اما Restart Loop مشکل را حل نمیکند. سقف Retry و ثبت علت لازم است. اگر مدل به دلیل OOM بالا نمیآید، Config باید Rollback شود.
استقرار Air-gapped و Cache مدل
برای شبکه جدا از اینترنت، Image، وزن، Tokenizer، License و Dependencyها باید از قبل Stage و Hash شوند. NIM امکان استفاده از Model Path محلی و Cache پایدار را مستند کرده است؛ اما زنجیره انتقال Artifact باید کنترل شود.
Cache روی دیسک پایدار از دانلود دوباره جلوگیری میکند. ظرفیت دیسک را برای چند ورژن مدل، Compile Cache و Log محاسبه کنید. پاکسازی نباید ورژن فعال یا امکان Rollback را حذف کند.
Secret دانلود فقط در مرحله دریافت لازم است و نباید داخل Image Bake شود. پس از انتقال به محیط بسته، Manifest و Hash تأیید میشوند تا Artifact دستکاریشده وارد سرویس نشود.
دو GX10 برای Serving چه تغییری ایجاد میکند؟
دو دستگاه میتوانند دو Replica مستقل برای دسترسپذیری و تقسیم ترافیک یا یک اجرای توزیعشده برای مدل بزرگتر باشید. این دو حالت متفاوتاند. Replica ظرفیت درخواست را افزایش میدهد؛ Model Parallel وزن یک مدل را تقسیم میکند.
در اجرای توزیعشده، Tensor یا Pipeline Parallelism به ارتباط پرسرعت و نرمافزار هماهنگ نیاز دارد. حافظه دو دستگاه یک Pool ساده نیست. Latency ارتباط و Failure یک Node باید در Benchmark دیده شوند.
برای سرویس حیاتی، دو Replica کوچکتر گاهی از یک مدل بسیار بزرگ توزیعشده پایدارتر است. انتخاب میان کیفیت مدل و Availability باید با نیاز کسبوکار انجام شود.
GX10، Cloud یا معماری ترکیبی؟
GX10 برای داده محلی، توسعه مداوم و کنترل زیرساخت مناسب است. Cloud برای Burst، مدلهای بسیار بزرگ و تیمی که نمیخواهد Runtime را نگهداری کند مزیت دارد. معماری ترکیبی میتواند درخواست حساس را محلی و بار عمومی را در سرویس دیگر اجرا کند.
Fallback ابری نباید مخفیانه داده را خارج کند. Classification داده و رضایت سازمان باید پیش از Route انجام شود. اگر Cloud در دسترس نیست، Client باید رفتار محدود اما شفاف داشته باشد.
مقیاس دیتاسنترهایی که در برنامه هوش مصنوعی متا یا قرارداد OpenAI و Oracle دیده میشود برای آموزش و سرویس جهانی است. GX10 جای آن زیرساخت نیست؛ ارزشش آوردن توسعه و Inference کنترلشده به میز تیم است.
پایلوت 30 روزه سرور مدل
- روز 1 تا 5: Workload، SLA، مدل و Dataset بار را تعریف کنید. یک Baseline تکدرخواست ثبت کنید.
- روز 6 تا 10: Runtime را در Container ورژندار اجرا و Model Cache، Chat Template، Streaming و Restart را تأیید کنید.
- روز 11 تا 15: Reverse Proxy، TLS، Authentication، Rate Limit، سقف Context و Log بدون متن را اضافه کنید.
- روز 16 تا 20: Concurrency Sweep و Soak Test را اجرا و TTFT، ITL، Throughput، Queue و Preemption را ثبت کنید.
- روز 21 تا 25: RAG، Structured Output یا Tool Calling واقعی را End-to-end آزمایش کنید. Failure و Cancellation را بسنجید.
- روز 26 تا 30: Dashboard، Alert، Canary و Rollback را کامل و تصمیم Go، اصلاح یا توقف را مستند کنید.
پایلوت باید خروجی عملی بدهد: مدل مشخص با Config مشخص تا چه Arrival Rateای SLA را نگه میدارد و هزینه هر هزار Token یا هر Task چقدر است. برای اتصال این سرویس به گردش کار، مقاله اتوماسیون سازمانی با هوش مصنوعی زمینه مکملی ارائه میکند.
خطاهای رایج در راهاندازی سرور مدل
- انتشار مستقیم Port vLLM روی اینترنت؛
- اعتماد به API Key داخلی بدون بررسی Endpointهای محافظتنشده؛
- انتخاب مدل بر اساس امکان Load شدن و نادیدهگرفتن KV Cache؛
- اعلام تعداد کاربر همزمان بدون تعریف طول Prompt و SLA؛
- Benchmark با یک Prompt کوتاه و تکراری؛
- ثبت میانگین Latency و حذف P95 و P99؛
- پذیرش صف نامحدود و Retry بینهایت؛
- ثبت متن کامل Prompt محرمانه در Log؛
- استفاده از Image و Model Revision با برچسب latest؛
- تفاوت Chat Template در Test و Production؛
- اجرای Tool Call بدون Policy و تأیید بیرون مدل؛
- فرض اینکه دو GX10 یک حافظه ساده 256GB میسازند.
چکلیست قبل از تحویل به کاربر
- مدل، مجوز، Revision و Tokenizer ثبت شدهاند.
- Runtime و Container روی ARM64 تأیید شدهاند.
- Client فقط از Reverse Proxy به سرویس دسترسی دارد.
- Endpointها Allowlist و TLS و Authentication فعالاند.
- سقف Input، Output، Context و Rate مشخص است.
- Queue محدود، Backpressure و Retry-After وجود دارد.
- TTFT، ITL، Throughput، Queue و خطا مانیتور میشوند.
- Benchmark با توزیع واقعی Prompt انجام شده است.
- Log حساس Redact و Retention تعیین شده است.
- Health Check، Graceful Shutdown و Rollback آزمایش شدهاند.
- RAG و Tool Calling با مجوز واقعی End-to-end سنجیده شدهاند.
پرسشهای متداول
آیا vLLM روی ASUS Ascent GX10 اجرا میشود؟
NVIDIA برای پلتفرم DGX Spark مبتنی بر GB10 Playbook رسمی vLLM منتشر کرده است. بااینحال، Image، Driver، Runtime و مدل موردنظر باید روی GX10 شما آزمایش شوند. راهنماهای x86 را نمیتوان بدون بررسی روی ARM64 کپی کرد.
vLLM بهتر است یا NVIDIA NIM؟
vLLM کنترل و اکوسیستم متنباز گستردهای میدهد. NIM Container و Profileهای یکپارچه با اکوسیستم NVIDIA ارائه میکند. انتخاب به مدل پشتیبانیشده، نیاز عملیات، مجوز، کنترل Config و Benchmark بستگی دارد.
GX10 چند کاربر همزمان را پاسخ میدهد؟
عدد عمومی وجود ندارد. مدل، Quantization، طول ورودی و خروجی، SLA و ترکیب درخواست ظرفیت را تعیین میکند. Concurrency Sweep با Workload واقعی باید نقطه شکست را نشان دهد.
آیا API سازگار با OpenAI یعنی همه برنامهها بدون تغییر کار میکند؟
خیر. مسیرها و ساختار پایه مشابهاند، اما قابلیت مدل، Tool Calling، Structured Output، پارامترها و Errorها ممکن است متفاوت باشید. Contract Test برای هر Client لازم است.
Prefix Caching همیشه سرعت را بیشتر میکند؟
فقط وقتی Prefix مشترک معناداری وجود داشته باشد. باید Hit Rate، حافظه و تغییر TTFT اندازهگیری شوند و در محیط چندمستاجری جداسازی Cache رعایت شود.
آیا اجرای محلی جای امنیت شبکه را میگیرد؟
خیر. Local بودن خروج داده را محدود میکند، اما Reverse Proxy، TLS، هویت، Firewall، Least Privilege، Audit، Patch و Backup همچنان ضروریاند.
کلام آخر
راهاندازی سرور مدل زبانی روی ASUS Ascent GX10 زمانی کامل است که مدل پشت یک API امن، محدود و قابل مشاهده قرار گیرد. vLLM و NVIDIA NIM مسیرهای قدرتمندی برای Serving هستند، اما Runtime بهتنهایی Production نمیسازد؛ Gateway، Queue، KV Cache، Benchmark، Monitoring و Rollback به همان اندازه مهماند.
حافظه یکپارچه 128GB و اکوسیستم GB10 امکان اجرای مدلهای جدی روی میز توسعه را فراهم میکند، ولی ظرفیت واقعی باید با Prompt و همزمانی واقعی اندازهگیری شود. ابتدا یک مدل و یک Endpoint را پایدار کنید، سپس RAG، Adapter و Agent را اضافه کنید. هر مرحله باید Metric، محدودیت و راه بازگشت خودش را داشته باشد.


پاسخگوی سوالات شما هستیم
دیدگاهی وجود ندارد!