


آنچه خواهید خواند
- OCR با Document Intelligence چه تفاوتی دارد؟
- معماری انتها به انتهای پردازش سند
- اول نوع PDF را تشخیص دهید
- چالشهای ویژه متن فارسی
- پیشپردازش؛ کمتر اما قابل اندازهگیری
- انتخاب موتور OCR فارسی
- Layout و ترتیب خواندن صفحه
- استخراج جدول؛ متن خطی کافی نیست
- استخراج فیلد و رابطه کلید-مقدار
- طبقهبندی، تفکیک و مسیریابی سند
- معیارهای ارزیابی که واقعاً اهمیت دارند
- Dataset آزمایش را چگونه بسازیم؟
- بازبینی انسانی را به بخش محصول تبدیل کنید
- امنیت و حریم خصوصی در پردازش محلی
- از سند ساختاریافته تا RAG سازمانی
- سازگاری نرمافزار با معماری ARM64
- ظرفیتسنجی GX10 بدون عددسازی
- یک پایلوت 30 روزه پیشنهادی
- خطاهای رایج در پروژه OCR سازمانی
- چکلیست تصمیم برای سازمان
- پرسشهای متداول
- کلام آخر
پردازش اسناد فارسی با ASUS Ascent GX10 چگونه انجام میشود؟
پردازش اسناد فارسی با ASUS Ascent GX10 یعنی فایلهای PDF، تصویر اسکنشده، فرم، فاکتور و نامه را در یک خط لوله محلی وارد کنیم؛ نوع صفحه را تشخیص دهیم، متن و ساختار را استخراج کنیم، جدول و فیلدهای مهم را بسنجیم و فقط خروجی معتبر را به سامانه سازمانی یا RAG تحویل دهیم. GX10 قدرت محاسباتی این زنجیره را فراهم میکند، اما خودش اسکنر، سامانه مدیریت اسناد یا سرویس آماده OCR نیست.
تفاوت اصلی یک پروژه سازمانی با «تبدیل عکس به متن» در کنترل کیفیت است. خروجی باید شماره صفحه، مختصات، فایل مادر، ورژن پردازش، Confidence و سابقه اصلاح انسانی داشته باشد. اگر هدف فقط استخراج چند خط از یک تصویر شخصی است، آموزش استخراج داده از تصاویر با ابزارهای گوگل مسیر سادهتری نشان میدهد؛ اما برای هزاران سند محرمانه، جدولهای چندصفحهای و اتصال به ERP، معماری دقیقتری لازم است.
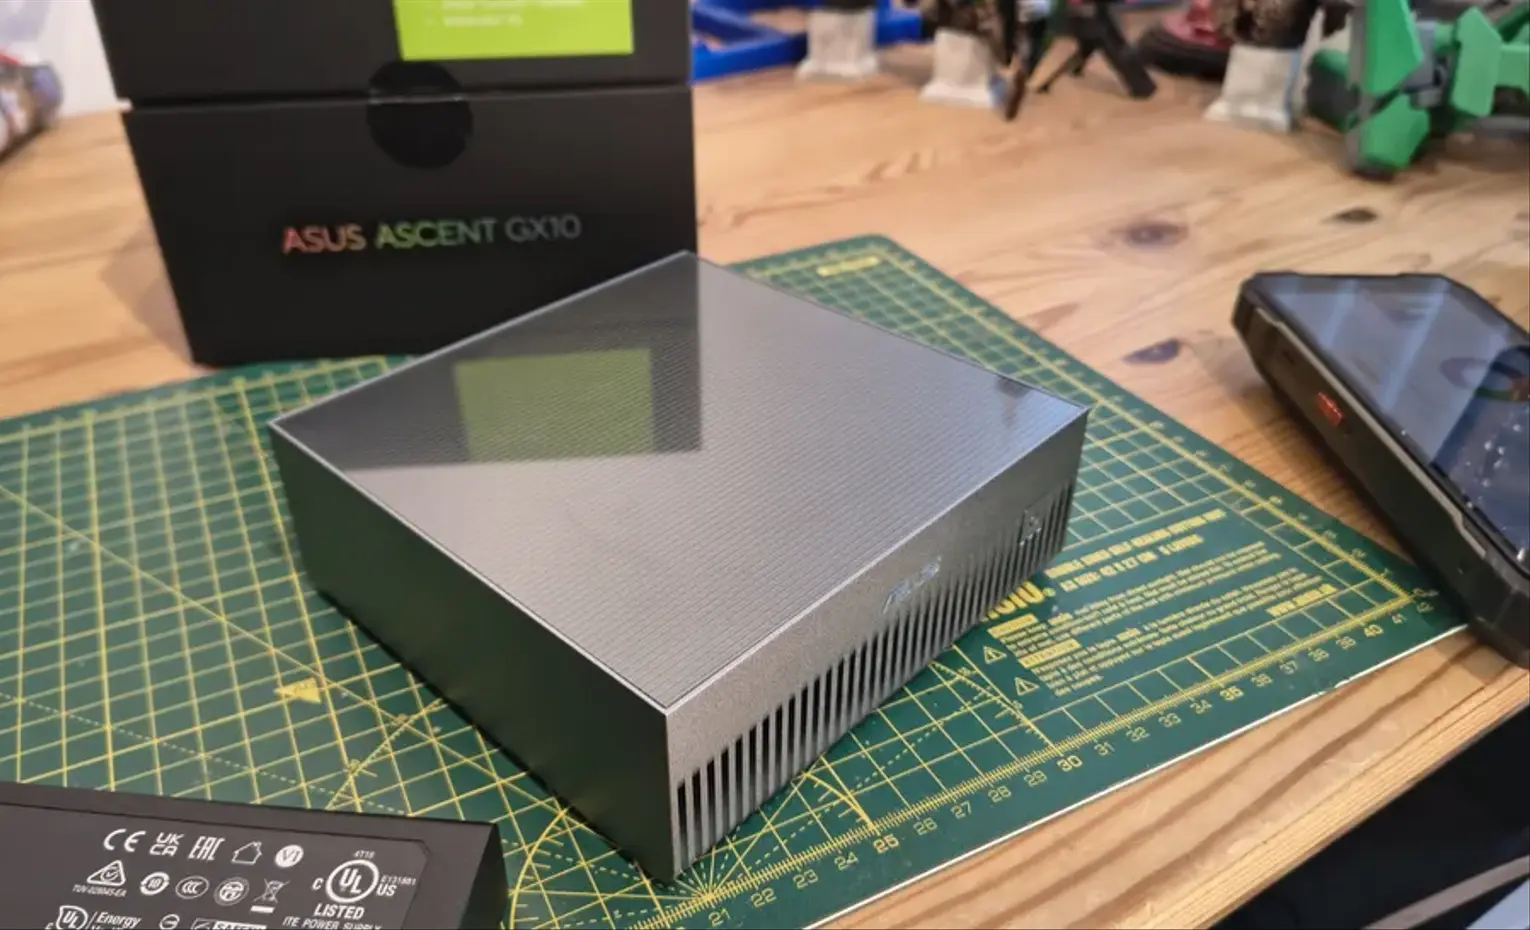
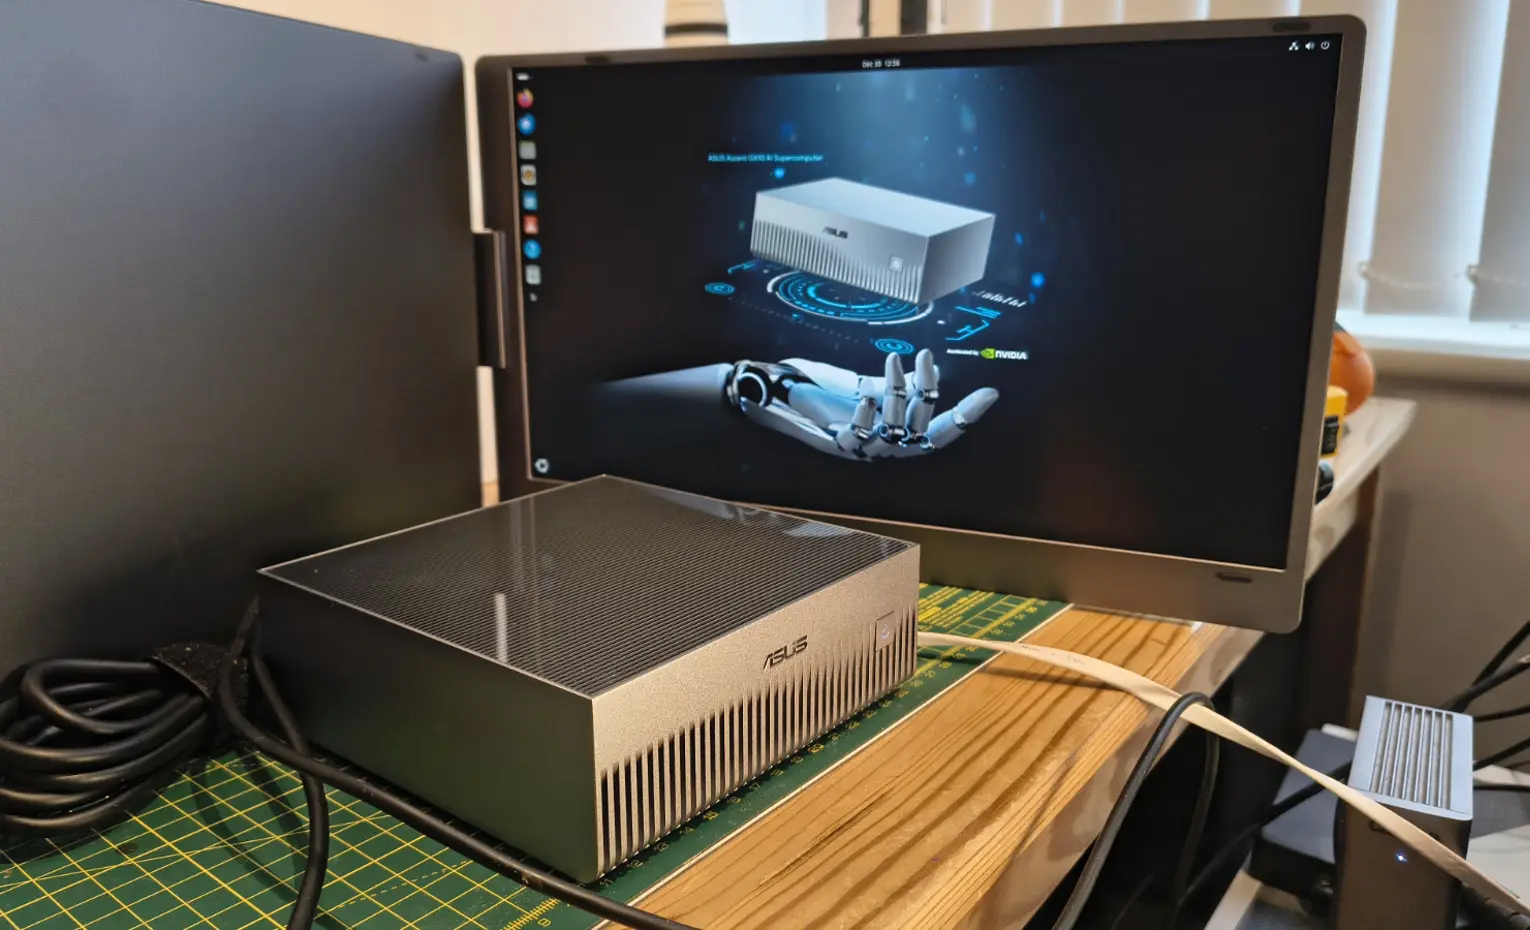
ورک استیشن هوش مصنوعی ایسوس مدل Ascent GX10 به پردازنده GB10 Grace Blackwell، حافظه یکپارچه 128GB LPDDR5x، Ubuntu Linux، شبکه 10GbE و SSD تا ظرفیت 4TB مجهز است. این ترکیب برای آزمایش مدل OCR، تشخیص Layout، مدل بیناییزبانی و پردازش Batch جذاب است. برای آشنایی با جایگاه سختافزار، ابتدا بررسی سوپر کامپیوتر ASUS Ascent GX10 و توضیح پردازنده GB10 Grace Blackwell را بخوانید.
OCR با Document Intelligence چه تفاوتی دارد؟
OCR فقط پیکسل را به نویسه تبدیل میکند. Document Intelligence علاوه بر متن، میپرسد تیتر کجاست، این عدد به کدام برچسب تعلق دارد، جدول چند ستون دارد، مهر روی کدام بخش افتاده و ترتیب خواندن صفحه چیست. برای جستجو در آرشیو، متن خام شاید کافی باشد؛ برای ثبت مبلغ فاکتور یا شماره قرارداد کافی نیست.
| سطح | ورودی | خروجی | نمونه کاربرد |
|---|---|---|---|
| OCR پایه | تصویر یا PDF اسکنشده | متن و مختصات | جستجوی کلمه در آرشیو |
| تحلیل Layout | صفحه پیچیده | تیتر، پاراگراف، جدول و تصویر | بازسازی ترتیب خواندن |
| استخراج فیلد | فرم یا فاکتور | کلید و مقدار استاندارد | شماره، تاریخ و مبلغ |
| طبقهبندی | فایل ناشناخته | نوع سند و مسیر ارجاع | تفکیک قرارداد از رسید |
| درک چندوجهی | متن، جدول و نمودار | نمای ساختاری یا پاسخ مستند | تغذیه RAG سازمانی |
یک مدل زبانی میتواند متن OCRشده را خلاصه کند، ولی خطای رقم را خودبهخود اصلاح نمیکند. اگر OCR مبلغ 850 را 8500 خوانده باشد، خلاصه روان همچنان اشتباه است. بنابراین هر مرحله باید خروجی و معیار مستقل داشته باشد و متن تولیدشده هرگز جای داده مبنا را نگیرد.
معماری انتها به انتهای پردازش سند
| مرحله | کار اصلی | خروجی قابل ثبت | ریسک رایج |
|---|---|---|---|
| ورود | دریافت از اسکنر، ایمیل یا DMS | شناسه و Hash فایل | تکرار یا فایل آلوده |
| تشخیص نوع | بررسی فرمت و وجود متن بومی | مسیر پردازش | OCR بیدلیل همه صفحات |
| رندر و پاکسازی | چرخش، برش، رفع نویز و نویز | تصویر استاندارد صفحه | حذف جزئیات ظریف |
| OCR و Layout | تشخیص نویسه و ناحیه | متن، مختصات و نوع بلوک | ترتیب خواندن غلط |
| ساختار | جدول، فیلد و رابطه برچسب-مقدار | JSON ورژندار | اتصال مقدار به برچسب اشتباه |
| اعتبارسنجی | قواعد دامنه و تطبیق مرجع | خطا و Confidence | اعتماد به نمره مدل |
| بازبینی | صف انسانی برای موارد مبهم | تصحیح و دلیل | تأیید سریع و بیدقت |
| تحویل | ارسال به ERP، CRM، DMS یا RAG | رکورد و Lineage | گمشدن پیوند با فایل اصلی |
GX10 معمولاً از رندر صفحه تا استنتاج مدل، استخراج ساختار و ساخت Embedding را اجرا میکند. سرویس ورود فایل، آنتیویروس، صف پیام، پایگاه داده، کنترل دسترسی و Backup اجزای جداگانهاند. معماری سالم مرز مسئولیت هر سرویس را مشخص میکند تا خرابی OCR کل گردش کار را متوقف نکند.
قرارگرفتن پردازش نزدیک منبع میتواند رفتوبرگشت داده را کم کند؛ ایدهای که در هاب پردازش محلی Anker MindBase نیز با مقیاسی متفاوت دیده میشود. در سازمان، این مزیت فقط زمانی واقعی است که مسیر ورود، سطح دسترسی و مقصد هر خروجی مستند باشد.
اول نوع PDF را تشخیص دهید
همه PDFها تصویر نیستند. PDF دیجیتال لایه متن دارد و استخراج مستقیم متن معمولاً سریعتر و دقیقتر از OCR است. PDF اسکنشده فقط تصویر صفحه را نگه میدارد. سند Mixed ممکن است چند صفحه متنی و چند صفحه اسکنشده داشته باشد. اجرای OCR کامل روی PDF دیجیتال میتواند نویسه درست را به خروجی کمدقتتر تبدیل کند.
مسیر Hybrid ابتدا وجود و سلامت متن بومی را میسنجد و فقط صفحه فاقد متن یا دارای متن خراب را به OCR میفرستد. تعداد نویسه، نسبت ناحیه متن، قابلیت Copy، فونتهای جاسازیشده و تطبیق تصویر با Text Layer نشانههای تصمیماند. فایل رمزدار، امضاشده یا دارای Attachment نیز به Policy جدا نیاز دارد.
DOCX و PPTX را میتوان مستقیماً Parse کرد یا برای حفظ چیدمان به PDF رندر کرد. مسیر دوم برای جدول و نمودار مفید است، اما باید فایل اصلی نیز نگهداری شود. تبدیل فرمت میتواند Comment، Track Changes، فرمول یا محتوای پنهان را از دست بدهد.
چالشهای ویژه متن فارسی
فارسی فقط «زبان راستبهچپ» نیست. ی و ک فارسی با ی و ک عربی کد متفاوت دارند، اعداد فارسی و لاتین مخلوط میشوند و نیمفاصله ممکن است حذف یا به فاصله کامل تبدیل شود. در نام کالا، کد فنی، شماره شبا و ایمیل نیز متن فارسی و لاتین در یک خط قرار میگیرند و ترتیب بصری با ترتیب منطقی تفاوت پیدا میکند.
Normalization باید هدفمند باشد. یکسانسازی ی و ک برای جستجو مفید است، اما تبدیل همه اعداد میتواند نمایش سند حقوقی را تغییر دهد. بهتر است متن خام OCR، متن نرمالشده و مقدار ساختاریافته سه فیلد جدا باشید. به این ترتیب هم تصویر اصلی قابل ممیزی است و هم جستجو خروجی یکنواخت میگیرد.
فونت ریز، چاپ کمرنگ، کاغذ کج، سایه اسکنر، مهر، امضا و زمینه رنگی دقت را کاهش میدهند. دستخط یک مسئله جدا از متن چاپی است؛ مطلب خواندن دستخط با هوش مصنوعی جذابیت این حوزه را نشان میدهد، اما در پروژه واقعی باید دستخط با Dataset سازمان سنجیده شود، نه با یک دموی عمومی.
پیشپردازش؛ کمتر اما قابل اندازهگیری
Deskew، تصحیح Perspective، حذف حاشیه، تنظیم Contrast و Denoise میتوانند خوانایی را بهتر کند. بااینحال، پاکسازی شدید نقطه اعشار، ممیز، خط جدول یا نشانه کمرنگ را حذف میکند. هر تبدیل باید ورژن داشته باشد و چند نمونه قبل و بعد آن بهصورت بصری بررسی شود.
DPI بالاتر همیشه بهتر نیست. افزایش رزولوشن حافظه و زمان استنتاج را زیاد میکند و گاهی نویز کاغذ را برجسته میسازد. اندازه مناسب به فونت، کیفیت اسکن و مدل بستگی دارد. یک Benchmark باید چند DPI و چند روش رندر را روی مجموعه ثابت مقایسه کند.
Orientation Detection نیز برای صفحات چرخیده لازم است. چرخش اشتباه 180 درجه میتواند Confidence ظاهراً قابل قبول ولی متن نامعتبر ایجاد کند. برای کتابچههای دوصفحهای، بریدن Spine و تفکیک صفحات پیش از OCR ضروری است. Thumbnail بازبین باید همان تصویری را نشان دهد که مدل دیده است.
انتخاب موتور OCR فارسی
PaddleOCR مدل چندزبانهای دارد که فارسی را در گروه خط عربی پوشش میدهد و Tesseract نیز فایل زبانی fas ارائه میکند. این پشتیبانی به معنی دقت تضمینی روی فاکتور، مهر یا اسکن سازمان شما نیست. ورژن مدل، نوع فونت، کیفیت تصویر و ترکیب فارسی-لاتین نتیجه را تغییر میدهند.
مقایسه باید روی Page Set واقعی انجام شود. موتور A ممکن است پاراگراف را بهتر بخواند و موتور B اعداد را دقیقتر تشخیص دهد. میتوان یک مسیر سریع برای صفحات ساده و مدل قویتر برای صفحات دشوار ساخت. Ensemble نیز ممکن است مفید باشد، ولی فقط وقتی اختلاف خروجی با یک قاعده روشن حل شود.
برای اسناد حساس، فرهنگ واژگان دامنه و Post-processing محدود کمک میکند. تصحیح «سامسونک» به «سامسونگ» در فهرست برندها منطقی است، اما تغییر خودکار شماره سریال خطرناک است. هر اصلاح باید نوع، Confidence و مقدار قبل از اصلاح را ثبت کند.
Layout و ترتیب خواندن صفحه
یک صفحه میتواند سربرگ، دو ستون، پانویس، جدول و مهر داشته باشد. اگر متن فقط از بالا به پایین مرتب شود، جملههای دو ستون درهم میشوند و شماره صفحه وارد محتوای اصلی میشود. مدل Layout باید ناحیهها را طبقهبندی کند و ترتیب خواندن با قواعد راستبهچپ هماهنگ شود.
مختصات Bounding Box را نگه دارید. این مختصات اجازه میدهد بازبین روی مقدار استخراجشده کلیک کند و همان بخش تصویر را ببیند. برای RAG نیز Citation صفحه و ناحیه ارزشمند است؛ پاسخ بدون قابلیت بازگشت به سند اصلی در محیط سازمانی قابل اعتماد نیست.
Header و Footer تکراری باید شناسایی شوند، اما حذف آنها نباید شماره ورژن یا سطح محرمانگی را پاک کند. جدول محتوا، حاشیهنویسی و Stamp هرکدام نقش متفاوتی دارند. خروجی Layout بهتر است نوع بلوک، مختصات، متن، صفحه و رابطه با بلوک والد را ثبت کند.
استخراج جدول؛ متن خطی کافی نیست
جدول مجموعهای از کلمات نیست؛ رابطه ردیف و ستون معنا میسازد. OCR ممکن است همه سلولها را درست بخواند ولی اتصال مبلغ به ردیف کالا را اشتباه کند. جدول بدون خط، سلول ادغامشده، تیتر چندسطحی و ادامه جدول در صفحه بعد چالشهای اصلیاند.
خروجی جدول را هم به شکل سلولمحور و هم نمایش انسانی نگه دارید. هر سلول به Row، Column، Span، Bounding Box و Confidence نیاز دارد. CSV برای جدول ساده مناسب است، اما JSON یا HTML روابط پیچیده را بهتر حفظ میکند. جمع ستون، تعداد ردیف و تطبیق مبلغ کل با جمع اقلام کنترلهای ارزان و مؤثرند.
در فاکتور، OCR اعداد کافی نیست. واحد پول، تخفیف، مالیات، جداکنده هزارگان و علامت منفی باید تفسیر شوند. اگر جمع اقلام با مبلغ نهایی نمیخواند، سند باید به صف بازبینی برود؛ مدل زبانی نباید اختلاف را با حدس پر کند.
استخراج فیلد و رابطه کلید-مقدار
برای هر نوع سند یک Schema تعریف کنید: قرارداد میتواند شماره، طرفین، تاریخ شروع و پایان داشته باشد؛ فاکتور فروشنده، شناسه مالیاتی، اقلام و مبلغ؛ پرونده خدماتی نیز شماره دستگاه، مدل و شرح خرابی. Schema باید نوع داده، الزامیبودن و قواعد اعتبار را تعیین کند.
Keyword Matching برای فرم ثابت شروع خوبی است، اما با جابهجایی چیدمان شکنده میشود. مدل Layout-aware موقعیت و متن را باهم میبیند و مدل بیناییزبانی میتواند پرسش «شماره قرارداد چیست؟» را از صفحه پاسخ دهد. بااینحال، پاسخ باید به ناحیه مستند متصل باشد و در صورت نبود فیلد صریح، مقدار null بدهد.
قواعد دامنه لایه دوم دفاعاند. تاریخ پایان نباید پیش از شروع باشد، شماره ملی Check Digit دارد، شناسه کالا باید در Master Data موجود باشد و مبلغ مالیات باید با نرخ مجاز سازگار باشد. این قواعد خطای مدل را آشکار میکند و نباید داخل Prompt پنهان بمانند.
طبقهبندی، تفکیک و مسیریابی سند
بسته اسکنشده ممکن است شامل چند سند باشد. Splitter باید مرز را از بارکد، صفحه سفید، سربرگ یا تغییر Layout تشخیص دهد. سپس Classifier نوع سند را تعیین میکند و آن را به Schema و Workflow مناسب میفرستد. اشتباه در این مرحله همه استخراجهای بعدی را منحرف میکند.
برای کلاسهای شبیه، Hierarchy بهتر از یک فهرست بلند است: ابتدا مالی، حقوقی، منابع انسانی یا فنی؛ سپس فاکتور، رسید یا صورتحساب. کلاس «نامشخص» ضروری است. مجبورکردن مدل به انتخاب یکی از کلاسهای شناختهشده، سند تازه را با Confidence کاذب وارد فرایند اشتباه میکند.
Agentها میتوانند مراحل را هماهنگ کند، ولی مجوز نامحدود نباید داشته باشید. مقاله ابزارهای ساخت Agent مفهوم گردش کار عاملمحور را توضیح میدهد. در سامانه اسناد، Agent بهتر است پیشنهاد مسیر بدهد و عملیات مالی یا حقوقی فقط پس از Policy و تأیید اجرا شود.
معیارهای ارزیابی که واقعاً اهمیت دارند
| لایه | معیار | پرسش عملی |
|---|---|---|
| متن | CER و WER | چند نویسه یا واژه اشتباه است؟ |
| فیلد | Exact Match و F1 | مقدار مهم دقیق استخراج شده است؟ |
| جدول | Cell Accuracy و Structure Match | سلول درست در جای درست قرار دارد؟ |
| طبقهبندی | Precision، Recall و Confusion Matrix | کدام نوع سند با کدام نوع اشتباه میشود؟ |
| عملیات | Pages/min، P95 Latency و Review Rate | صف با بار واقعی پایدار میماند؟ |
| کسبوکار | نرخ ورود بدون اصلاح و هزینه هر سند | فرایند واقعاً سریعتر و کمخطاتر شده است؟ |
Accuracy کلی میتواند خطرناک باشد. اگر همه پاراگرافها درست و تنها شماره حساب غلط باشد، امتیاز صفحه بالا میماند ولی خروجی عملی غیرقابل استفاده است. معیار هر فیلد باید با هزینه خطای همان فیلد وزن بگیرد؛ شماره حساب و مبلغ از توضیح آزاد اهمیت بیشتری دارند.
Confidence مدل باید Calibration شود. نمره 0٫9 لزوماً به معنی احتمال 90 درصد صحت نیست. داده را در بازههای نمره گروهبندی کنید و نرخ واقعی خطا را بسنجید. Threshold تأیید خودکار، بازبینی و رد باید از این نمودار و هزینه خطا به دست آید.
Dataset آزمایش را چگونه بسازیم؟
نمونهها باید تنوع واقعی را پوشش دهند: اسکن قدیمی و جدید، چند شعبه، چند فروشنده، چند فونت، صفحه کج، مهر، فتوکپی و سند دو زبانه. انتخاب فقط بهترین فایلها یک Demo زیبا میسازد، نه برآورد تولید. موارد دشوار باید عمداً در مجموعه آزمون حضور داشته باشید.
Train و Test را بر اساس Template، فروشنده و زمان جدا کنید. اگر صفحات یک فرم در هر دو مجموعه باشید، مدل ظاهر Template را حفظ میکند و نتیجه خوشبینانه میشود. یک آزمون جدا با Template دیدهنشده، توان تعمیم را نشان میدهد.
برچسب مرجع باید دوبار بررسی شود. اختلاف دو Annotator برای عدد یا مرز جدول نشان میدهد تعریف برچسب مبهم است. Guideline باید درباره نیمفاصله، ارقام، فیلد خالی، مهر روی متن و سلول ادغامشده تصمیم روشن داشته باشد.
بازبینی انسانی را به بخش محصول تبدیل کنید
Human-in-the-loop یک جعبه ایمیل برای همه اسناد نیست. رابط باید تصویر و Crop فیلد، مقدار پیشنهادی، دلیل ارجاع و کلیدهای سریع را نشان دهد. بازبین نباید برای پیدا کردن یک عدد میان ده صفحه جستجو کند. ترتیب صف نیز باید بر اساس ریسک و موعد پردازش باشد.
سه مسیر ساده تعریف کنید: تأیید خودکار برای فیلد کمخطر با Confidence کالیبرهشده، بازبینی برای مورد مبهم و رد برای فایل غیرقابل خواندن. فاکتور، قرارداد، پرونده پزشکی یا تصمیم حقوقی نباید فقط با خروجی مدل تأیید نهایی شوند. مسئولیت انسانی و کنترل دو مرحلهای باید مطابق حساسیت فرایند باقی بماند.
اصلاح بازبین داده ارزشمند است، اما مستقیم وارد Train نشود. ابتدا نمونه، کاربر، زمان و دلیل تغییر ثبت و Audit شود. اشتباه تایپی بازبین یا تغییر Policy میتواند مدل بعدی را آلوده کند.
امنیت و حریم خصوصی در پردازش محلی
اجرای محلی میتواند خروج فایل به سرویس ابری را کاهش دهد، اما «محلی» مترادف «امن» نیست. کنترل دسترسی، رمزگذاری دیسک و انتقال، مدیریت Secret، Patch، ثبت رویداد، Backup و حذف دورهای همچنان لازماند. حساب سرویس OCR نباید به کل آرشیو دسترسی نوشتن داشته باشد.
قبل از Index یا آموزش، داده حساس را طبقهبندی کنید. شماره ملی، حساب بانکی، اطلاعات سلامت و قرارداد محرمانه ممکن است به Masking یا Retention جدا نیاز داشته باشید. متن استخراجشده نیز به اندازه تصویر اصلی حساس است و نباید بدون Policy در Log یا Notebook باقی بماند.
معماری محلی مشابه ایده پردازش نزدیک منبع در بررسی محدودیتهای هوش مصنوعی محلی است، اما GX10 منابع بیشتری دارد. در مقابل، سازمان باید خودش امنیت چرخه عمر را اداره کند. بحث حریم خصوصی در هوش مصنوعی اپل نیز نشان میدهد محل پردازش فقط یکی از اجزای اعتماد است.
از سند ساختاریافته تا RAG سازمانی
RAG باید مصرفکنده خروجی پاک و مستند باشد، نه جایگزین OCR و Layout. ابتدا متن، جدول، صفحه و Metadata استخراج میشوند؛ سپس Chunk بر اساس تیتر و مرز منطقی ساخته میشود. بریدن ثابت هر 500 نویسه میتواند ردیف جدول یا بند قرارداد را از زمینه جدا کند.
هر Chunk باید شناسه سند، ورژن، صفحه، سطح دسترسی و Bounding Box داشته باشد. هنگام پاسخ، سیستم فقط اسناد مجاز کاربر را جستجو میکند و Citation را به صفحه اصلی برمیگرداند. حذف یک سند از DMS باید ورژن Indexشده را نیز بیاعتبار کند.
Embeddings متنی برای پاراگراف مناسباند، اما جدول و نمودار ممکن است به نمایش ساختاری یا چندوجهی نیاز داشته باشید. NVIDIA NeMo Retriever مسیرهای جدا برای متن، جدول، نمودار و تصویر دارد؛ انتخاب آنها باید با سؤالهای واقعی سازمان آزمایش شود. زیرساخت بزرگتر همیشه پاسخ دقیقتر نمیسازد؛ همانطور که مقیاس دیتاسنترهای هوش مصنوعی با یک ایستگاه کاری رومیزی هدف متفاوتی دارد.
سازگاری نرمافزار با معماری ARM64
GX10 پردازنده ARM دارد. پیش از خرید یا استقرار باید Image کانتینر، Wheel پایتون، موتور PDF، درایور اسکنر، کتابخانه OCR و Connector سازمانی روی ARM64 بررسی شوند. وجود ورژن x86 به معنی وجود ورژن ARM نیست و Emulation میتواند کارایی یا پایداری را تغییر دهد.
یک Proof of Compatibility بسازید: کانتینر را روی سیستم هدف اجرا کنید، PDF فارسی را Parse کنید، مدل را Load کنید، جدول را استخراج کنید و خروجی را به پایگاه داده آزمایشی بفرستید. سپس ورژن OS، Driver، CUDA، مدل و Dependencyها را Freeze کنید.
Notebook توسعه برای Production کافی نیست. سرویس باید Health Check، Queue، Retry محدود، Dead Letter، Timeout و Monitoring داشته باشد. فایل خراب نباید Worker را برای همیشه اشغال کند و Retry بینهایت نباید صف را متوقف سازد.
ظرفیتسنجی GX10 بدون عددسازی
نمیتوان یک عدد ثابت «صفحه در دقیقه» برای GX10 اعلام کرد. سرعت به DPI، اندازه صفحه، تعداد Region، موتور OCR، مدل Layout، Precision، Batch Size و نسبت PDF متنی به اسکنشده بستگی دارد. صفحات ساده چند برابر سند پیچیده سرعت دارند.
Benchmark را با ترکیب واقعی بار اجرا کنید؛ مثلاً 40 درصد PDF متنی، 40 درصد اسکن چاپی و 20 درصد جدول سنگین. Warm-up، زمان رندر، انتقال، Post-processing و ثبت پایگاه داده را حساب کنید. فقط زمان GPU تصویر کاملی از تجربه کاربر نمیدهد.
P50 میانگین معمول را نشان میدهد، ولی P95 و طول صف برای SLA مهمترند. مصرف حافظه، دمای دستگاه، خطای Worker و Backpressure نیز ثبت شوند. تست یکساعته برای کشف Memory Leak یا افت طولانی کافی نیست؛ Soak Test چندساعته یا چندروزه لازم است.
اگر بار شبانه است، Batch Processing ظرفیت را بهتر استفاده میکند. برای کاربر تعاملی، صف اولویتدار و مدل سبکتر ممکن است مهمتر از Throughput کل باشد. Cloud Burst نیز میتواند برای اوج بار استفاده شود، ولی اسناد محرمانه و سیاست خروج داده باید از قبل تعیین شوند.
یک پایلوت 30 روزه پیشنهادی
- روز 1 تا 5: یک نوع سند و سه فیلد مهم انتخاب کنید؛ 500 تا 1000 صفحه متنوع را با مجوز مناسب گردآوری و معیار موفقیت را تعریف کنید.
- روز 6 تا 10: تشخیص نوع PDF، رندر، OCR پایه و ذخیره Lineage را بسازید. نمونههای خراب و تکراری را جدا کنید.
- روز 11 تا 15: دو موتور یا دو تنظیم را با CER، دقت فیلد و زمان مقایسه کنید. مسیر فارسی-لاتین و Normalization را تثبیت کنید.
- روز 16 تا 20: استخراج جدول یا کلید-مقدار، قواعد دامنه و صف بازبینی را اضافه کنید. Thresholdها را از داده کالیبره کنید.
- روز 21 تا 25: Connector آزمایشی به DMS یا ERP بسازید، دسترسی و Audit را آزمایش و خطاهای End-to-end را ثبت کنید.
- روز 26 تا 30: Load Test، نمونهبرداری کیفی و محاسبه هزینه هر سند را انجام دهید. تصمیم Go، اصلاح یا توقف را با شواهد بگیرید.
هدف پایلوت نباید «نمایش هوش مصنوعی» باشد. خروجی مطلوب یک Baseline شفاف است: چند درصد فیلد بدون اصلاح عبور میکند، چند درصد به بازبینی میرود، زمان و هزینه چقدر است و خطا در کدام Template رخ میدهد. برای نگاه گستردهتر به فرایند، مقاله اتوماسیون سازمانی با هوش مصنوعی زمینه مکملی ارائه میکند.
خطاهای رایج در پروژه OCR سازمانی
- فرستادن همه PDFها به OCR بدون تشخیص Text Layer؛
- گزارش Accuracy کلی و پنهانکردن خطای مبلغ یا شناسه؛
- استفاده از Dataset تمیز و حذف اسکنهای دشوار از آزمون؛
- نادیدهگرفتن تفاوت ی، ک، اعداد و ترتیب راستبهچپ؛
- تبدیل جدول به متن خطی و از دستدادن رابطه سلولها؛
- تأیید خودکار خروجی حساس فقط بر اساس Confidence خام؛
- ذخیره متن بدون صفحه، مختصات و ورژن فایل مادر؛
- انتخاب مدل پیش از بررسی سازگاری ARM64 و کانتینرها؛
- محاسبه ظرفیت فقط با زمان استنتاج و حذف رندر و Queue؛
- ورود اصلاحهای بازبین به آموزش بدون ممیزی.
چکلیست تصمیم برای سازمان
- نوع سند، مالک فرایند و هزینه خطا روشن است.
- فایل اصلی، Hash، ورژن و سیاست نگهداری ثبت میشود.
- PDF متنی، اسکنشده و Mixed مسیر جدا دارند.
- Dataset فارسی شامل اسکن دشوار، جدول و متن ترکیبی است.
- دقت در سطح فیلد و جدول سنجیده میشود.
- Confidence با نرخ خطای واقعی کالیبره شده است.
- بازبین تصویر و Crop مرتبط را میبیند.
- اسناد حساس کنترل دسترسی و Audit دارند.
- Dependencyهای ARM64 روی GX10 آزمایش شدهاند.
- Throughput و P95 با بار واقعی اندازهگیری شدهاند.
- هیچ خروجی مالی، حقوقی یا پزشکی بدون کنترل مناسب نهایی نمیشود.
پرسشهای متداول
آیا ASUS Ascent GX10 نرمافزار OCR فارسی آماده دارد؟
خیر. GX10 یک سیستم محاسباتی مبتنی بر Ubuntu و پلتفرم NVIDIA است. باید موتور OCR، مدل Layout، قواعد اعتبارسنجی، رابط بازبینی و اتصال سازمانی را انتخاب و پیادهسازی کنید.
آیا PaddleOCR یا Tesseract برای فارسی کافی است؟
هر دو پشتیبانی فارسی دارند و میتوانند Baseline خوبی باشید، اما کافیبودن فقط با اسناد واقعی شما مشخص میشود. متن چاپی ساده، جدول، مهر و دستخط نتایج متفاوتی میدهند.
آیا مدل زبانی میتواند خطای OCR را اصلاح کند؟
میتواند برخی خطاهای زبانی را پیشنهاد دهد، ولی برای عدد، نام، کد و مبلغ ممکن است پاسخ ظاهراً معقول اما نادرست بسازد. مقدار خام، اصلاحشده و دلیل اصلاح باید جدا ثبت و موارد حساس بازبینی شوند.
آیا 128GB حافظه برای پردازش سند کافی است؟
برای بسیاری از پایلوتها و مدلهای OCR، Layout و VLM ظرفیت قابل توجهی است، ولی کافیبودن به مدل، رزولوشن، Batch و همزمانی بستگی دارد. اندازه مدل و Peak Memory باید روی Workflow نهایی اندازهگیری شود.
آیا پردازش محلی نیاز به Cloud را حذف میکند؟
نه الزاماً. سازمان میتواند اسناد حساس و بار عادی را محلی نگه دارد و برای پشتیبانگیری یا اوج بار از زیرساخت دیگر استفاده کند. محل پردازش باید با امنیت، هزینه و SLA انتخاب شود.
ارتباط این خط لوله با RAG چیست؟
این خط لوله مرحله قبل از RAG است. ابتدا سند به متن و ساختار قابل استناد تبدیل میشود؛ سپس Chunk، Embedding و Retrieval روی خروجی معتبر ساخته میشوند. RAG نمیتواند ساختار گمشده یا رقم اشتباه OCR را تضمینی بازیابی کند.
کلام آخر
پردازش اسناد فارسی با ASUS Ascent GX10 زمانی ارزشمند است که از یک OCR نمایشی فراتر برویم. تشخیص نوع PDF، پیشپردازش کنترلشده، OCR فارسی، تحلیل Layout، استخراج جدول و فیلد، اعتبارسنجی دامنه، بازبینی انسانی و Lineage باید در یک زنجیره قابل ممیزی قرار گیرند.
GX10 با حافظه یکپارچه 128GB و پلتفرم محاسباتی NVIDIA میتواند میزبان قدرتمندی برای توسعه و اجرای محلی این زنجیره باشد، اما عدد ظرفیت، دقت فارسی و سازگاری نرمافزار باید روی Dataset و Container واقعی اندازهگیری شوند. پایلوت خوب با یک نوع سند، چند فیلد پرارزش و معیار خطای روشن شروع میشود؛ نه با وعده دیجیتالیکردن کل آرشیو در روز اول.


پاسخگوی سوالات شما هستیم
دیدگاهی وجود ندارد!