


آنچه خواهید خواند
- آیا مسئله شما واقعاً به Fine-tuning نیاز دارد؟
- تفاوت Full Fine-tuning، LoRA و QLoRA
- حافظه 128GB GX10 را درست تفسیر کنید
- Dataset فارسی باید چه شکلی داشته باشد؟
- کیفیت مهمتر از تعداد نمونه است
- Train، Validation و Test را چگونه جدا کنیم؟
- Tokenizer و Chat Template؛ خطای پنهان پروژه
- ساخت محیط آموزش روی معماری ARM64
- پارامترهای LoRA چه معنایی دارند؟
- Batch، Gradient Accumulation و Packing
- Training Run را چگونه مانیتور کنیم؟
- ارزیابی مدل فارسی فقط BLEU یا Loss نیست
- Safety، Prompt Injection و داده سمی
- LoRA، RAG و Prompt را چگونه ترکیب کنیم؟
- Adapter را Merge کنیم یا جدا نگه داریم؟
- یک GX10 یا دو دستگاه؟
- پایلوت 30 روزه فاینتیون فارسی
- خطاهای رایج در Fine-tuning مدل فارسی
- چکلیست پیش از شروع آموزش
- پرسشهای متداول
- کلام آخر
فاین تیون مدل فارسی با ASUS Ascent GX10 چگونه انجام میشود؟
فاین تیون مدل فارسی با ASUS Ascent GX10 یعنی یک مدل زبانی ازپیشآموزشدیده را با داده کنترلشده فارسی برای لحن، قالب پاسخ، اصطلاحات تخصصی یا یک وظیفه مشخص سازگار کنیم. برای شروع معمولاً LoRA یا QLoRA منطقیتر از آموزش همه پارامترهاست، زیرا تعداد وزنهای قابلآموزش و مصرف حافظه را کاهش میدهد. بااینحال، نتیجه خوب بیش از آنکه به تعداد Epoch وابسته باشد، به کیفیت Dataset، انتخاب مدل پایه و ارزیابی مستقل بستگی دارد.
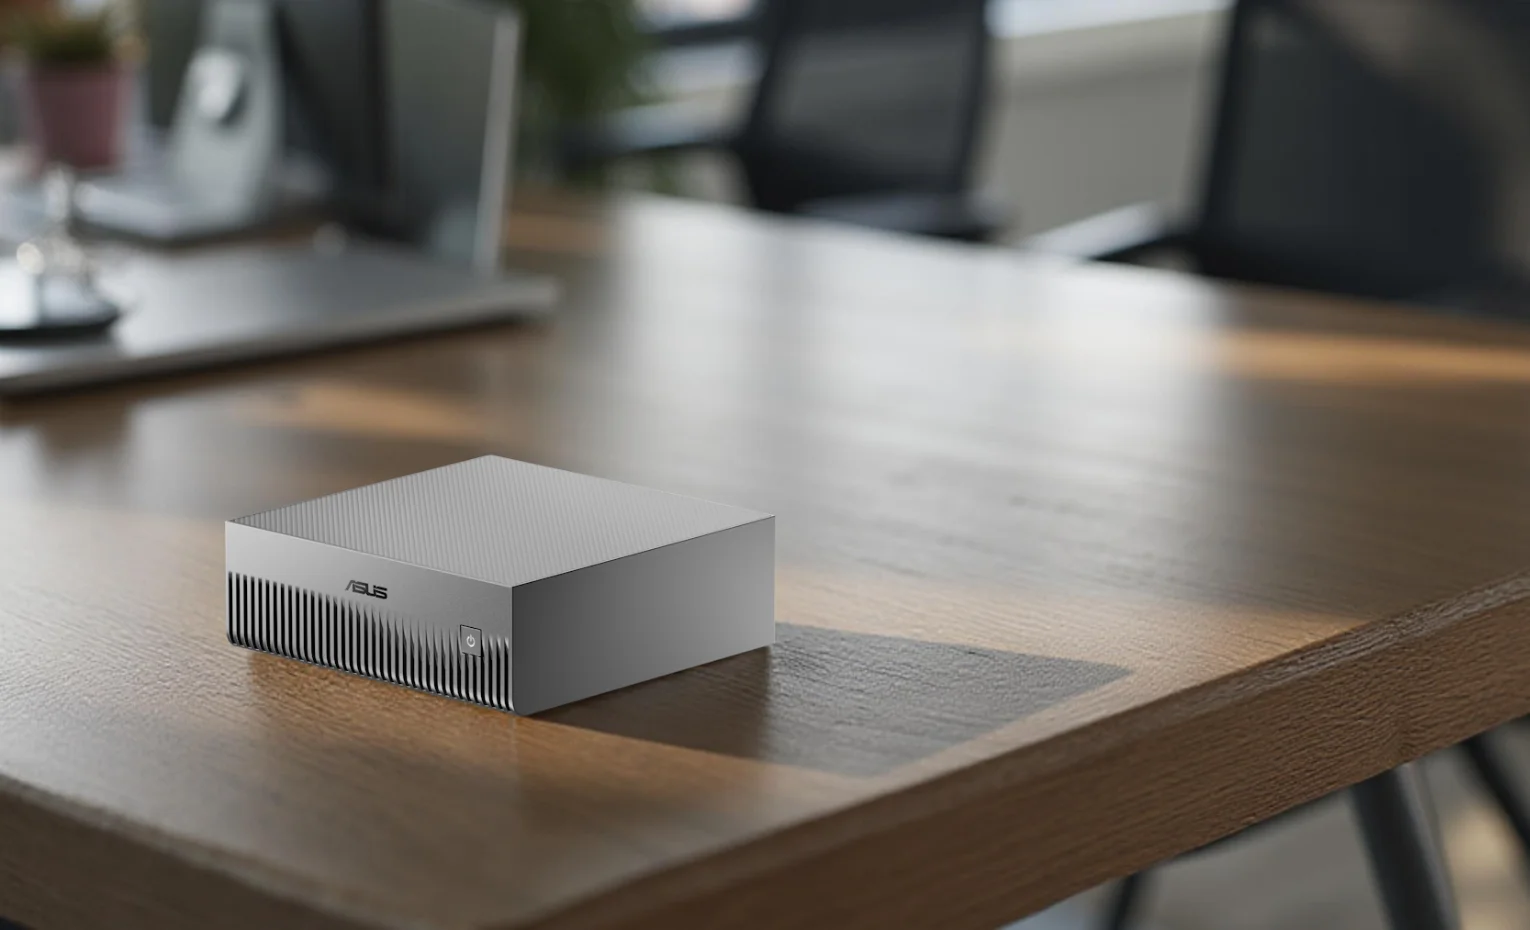
ورک استیشن هوش مصنوعی ایسوس مدل Ascent GX10 از پردازنده NVIDIA GB10 Grace Blackwell، حافظه یکپارچه 128GB LPDDR5x، سیستمعامل Ubuntu Linux و شبکه 10GbE استفاده میکند. این مشخصات آن را به بستری جدی برای آزمایش محلی Fine-tuning تبدیل میکند؛ اما عدد 1 PFLOP اعلامشده برای Tensor Performance بهتنهایی زمان آموزش یک مدل مشخص را پیشبینی نمیکند. برای شناخت کامل دستگاه، بررسی سوپر کامپیوتر ASUS Ascent GX10 و توضیح پردازنده GB10 Grace Blackwell را بخوانید.
این مقاله یک دستور جادویی برای «فارسیکردن هر مدل» نیست. ابتدا بررسی میکنیم آیا Fine-tuning واقعاً لازم است، سپس LoRA و QLoRA، معماری داده فارسی، بودجه حافظه، تنظیم آموزش، ارزیابی و استقرار Adapter را مرحلهبهمرحله طراحی میکنیم. هیچ مدل، سرعت یا کیفیتی بدون Benchmark روی داده واقعی تضمین نمیشود.
آیا مسئله شما واقعاً به Fine-tuning نیاز دارد؟
بسیاری از تیمها Fine-tuning را با افزودن دانش تازه اشتباه میگیرند. اگر هدف پاسخ از روی اسناد متغیر، قیمت روز، آییننامه جدید یا پرونده مشتری است، RAG معمولاً انتخاب مناسبتری است؛ چون منبع را هنگام پاسخ بازیابی میکند و به Citation متصل میماند. Fine-tuning برای تغییر رفتار، سبک، قالب و مهارت پایدار مناسبتر است.
| نیاز | راه آغازین | دلیل |
|---|---|---|
| لحن و قالب ثابت پاسخ | Prompt و سپس LoRA | رفتار تکرارشونده هدف اصلی است |
| پاسخ از اسناد بهروزشونده | RAG | دانش بیرون از وزن مدل میماند |
| استخراج JSON از متن | Prompt، Grammar و SFT | ساختار خروجی قابل ارزیابی است |
| واژگان تخصصی فارسی | RAG یا LoRA بر اساس خطا | دانش و رفتار باید جدا سنجیده شوند |
| یادگیری زبان از صفر | Continued Pretraining | SFT کوچک جای پیشآموزش را نمیگیرد |
| کاهش هزینه سرویس خارجی | مدل کوچکتر، Distillation یا Quantization | Fine-tuning الزاماً مدل را سریع نمیکند |
با 50 تا 100 نمونه واقعی ابتدا Prompt Baseline بسازید. اگر مدل پایه با دستور روشن، چند مثال و خروجی ساختاریافته به هدف میرسد، پیچیدگی آموزش لازم نیست. اگر خطا در الگوی رفتاری تکرار میشود و Prompt بیش از حد بلند یا شکننده است، Fine-tuning ارزش بررسی دارد.
مدل پایه نیز باید پیش از آموزش انتخاب شود. مجوز استفاده، کیفیت فارسی، طول Context، معماری، Tokenizer و پشتیبانی ابزارها را بررسی کنید. مقاله آشنایی با مدلها و اکوسیستم Mistral AI نمونهای از تفاوت اکوسیستم مدلها را نشان میدهد؛ اما انتخاب نهایی باید با Model Card و مجوز همان ورژن انجام شود.
تفاوت Full Fine-tuning، LoRA و QLoRA
| روش | چه چیزی آموزش میبیند؟ | مزیت | محدودیت |
|---|---|---|---|
| Full Fine-tuning | بیشتر یا همه وزنهای مدل | بیشترین آزادی تغییر | حافظه، زمان و ریسک فراموشی بیشتر |
| LoRA | ماتریسهای کمرتبه کنار وزن منجمد | Adapter کوچک و قابل تعویض | به انتخاب Rank و Target Module حساس است |
| QLoRA | LoRA روی مدل پایه Quantized | کاهش بیشتر حافظه وزن پایه | پیچیدگی Quantization و سازگاری Kernel |
LoRA وزن اصلی را منجمد نگه میدارد و تغییرات را با دو ماتریس کمرتبه یاد میگیرد. بهجای ذخیره ورژن کامل برای هر وظیفه، میتوان Adapterهای جدا برای پشتیبانی، استخراج داده یا نگارش ساخت. این جداسازی مدیریت ورژن و آزمایش A/B را سادهتر میکند.
QLoRA مدل پایه را معمولاً در 4-bit نگه میدارد و Gradient را از مسیر وزنهای Quantized به Adapterهای قابلآموزش منتقل میکند. این روش حافظه موردنیاز را کاهش میدهد، اما «چهار برابر سریعتر» یا «بدون افت کیفیت» یک قانون عمومی نیست. نوع Quantization، Kernel، مدل و Dataset روی نتیجه اثر دارند.
Full Fine-tuning برای مدل کوچک یا نیاز پژوهشی خاص قابل بررسی است. در مدلهای بزرگ، علاوه بر وزنها باید Gradient، Optimizer State و Activationها را نیز در حافظه جا داد. به همین دلیل ظرفیت پارامتر قابل اجرا برای Inference با ظرفیت قابل آموزش کامل یکسان نیست.
حافظه 128GB GX10 را درست تفسیر کنید
حافظه یکپارچه 128GB مزیت مهم GX10 است، زیرا CPU و GPU به یک فضای مشترک دسترسی دارند و مدلهای بزرگتری نسبت به کارتهای با VRAM کمتر قابل آزمایشاند. بااینحال، این حافظه بین سیستمعامل، Container، وزن مدل، KV/Activation، Gradient، Optimizer و Dataset Cache تقسیم میشود.
بودجه حافظه را پیش از اجرا بنویسید. وزن Quantized تنها یک جزء است. Sequence Length بلند Activation را افزایش میدهد، Batch Size بزرگ Peak Memory را بالا میبرد و Optimizer انتخابی نیز State نگه میدارد. Fragmentation و Workspace کتابخانهها باید حاشیه امن داشته باشید.
ادعای بازاریابی سختافزار را با Workload اشتباه نگیرید. توان FP4 برای عملیات Tensor خاص اعلام میشود و زمان SFT به Precision، Attention Kernel، طول توالی، I/O و نرمافزار بستگی دارد. مقاله فریب برچسب AI در بازاریابی پردازندهها همین فاصله میان نامگذاری و عملکرد واقعی را یادآوری میکند.
اگر Out of Memory رخ داد، فقط مدل را کوچک نکنید. ابتدا Batch Size، Sequence Length، Gradient Checkpointing، Gradient Accumulation، Packing و Optimizer را بررسی کنید. کاهش طول توالی ممکن است از کاهش Rank مؤثرتر باشد؛ اما اگر وظیفه به متن بلند نیاز دارد، این تغییر کیفیت را محدود میکند.
Dataset فارسی باید چه شکلی داشته باشد؟
Dataset یک پوشه از متنهای فارسی نیست. هر نمونه باید هدف آموزشی مشخص داشته باشد: دستور، Context اختیاری، پاسخ مطلوب و Metadata. برای چت چندنوبتی نیز نقش System، User و Assistant باید دقیقاً با Chat Template مدل هماهنگ باشد.
نمونه خوب پاسخ درست، لحن مناسب، طول هدف و رفتار هنگام نبود اطلاعات را نشان میدهد. فقط پاسخهای مثبت نسازید؛ مدل باید رد درخواست نامعتبر، درخواست توضیح و اعلام عدم اطمینان را نیز ببیند. اگر همه پاسخها بسیار طولانی باشید، مدل در سؤال ساده هم پرگویی میکند.
داده فارسی به تصمیمهای Normalization نیاز دارد. «ی» و «ک» فارسی و عربی، اعداد فارسی و لاتین، فاصله و نیمفاصله، علائم نقلقول و متن راستبهچپ باید با Policy یکنواخت پردازش شوند. مقدار خام را نیز نگه دارید تا در صورت خطای Normalizer امکان بازسازی وجود داشته باشد.
متن ترکیبی فارسی و انگلیسی را حذف نکنید. نام مدل، کد کالا، URL، شماره ورژن و اصطلاحات فنی معمولاً لاتیناند. Dataset کاملاً پاک و مصنوعی ممکن است روی مکالمه واقعی که Code-switching دارد ضعیف عمل کند. توزیع داده باید زبان کاربران را بازتاب دهد، نه سلیقه ویرایشگر.
کیفیت مهمتر از تعداد نمونه است
هزار نمونه متناقض میتواند از صد نمونه دقیق بدتر باشد. Guideline برچسبگذاری باید لحن، منبع مجاز، طول پاسخ، قالب، برخورد با ابهام و واژگان ممنوع را تعریف کند. چند Annotator باید روی یک زیرمجموعه مشترک کار کند تا اختلافها دیده شود.
Deduplication ضروری است. تکرار یک نمونه وزن آن رفتار را بیدلیل بالا میبرد و اگر ورژن مشابه در Train و Test باشد، نتیجه آزمون خوشبینانه میشود. شباهت لفظی، Template تکراری و پاسخهای تولیدشده با جایگزینی چند نام باید جدا بررسی شوند.
داده مصنوعی میتواند پوشش را افزایش دهد، اما نباید خودش معیار حقیقت باشد. نمونه تولیدشده باید با قواعد دامنه و بازبینی انسانی پالایش شود. اگر یک مدل بزرگ پاسخ مصنوعی ساخته، مدل کوچک ممکن است خطا و سبک همان مدل را تقلید کند.
اطلاعات شخصی، قرارداد و مکالمه مشتری به مجوز و Masking نیاز دارند. حذف نام تنها کافی نیست؛ شماره تلفن، ایمیل، آدرس، شماره سفارش و ترکیب چند فیلد میتوانند فرد را قابلشناسایی کند. Retention Dataset و دسترسی به Checkpoint باید تعریف شود.
Train، Validation و Test را چگونه جدا کنیم؟
Split تصادفی برای دادههای سازمانی همیشه امن نیست. مکالمههای یک مشتری، اسناد یک پرونده یا نمونههای یک Template باید در یک Split بمانند. در غیر این صورت مدل ساختار همان پرونده را در Train میبیند و در Test بازشناسی میکند.
Test زمانی برای داده زنده مهم است: Train روی ماههای قدیمی و Test روی بازه جدید. این روش تغییر واژگان، محصولات و رفتار مشتری را آشکار میکند. برای سنجش تعمیم، یک Test جدا از بخش، محصول یا موضوعی که مدل ندیده است نیز بسازید.
Validation برای انتخاب Hyperparameter است و نباید بارها با Test اصلی تنظیم شود. Test نهایی تا پایان تصمیمگیری دستنخورده میماند. یک Challenge Set کوچک از موارد دشوار مانند ابهام، متن شکسته، سؤال خارج از دامنه و Prompt Injection نیز مفید است.
Leakage فقط کپی متن نیست. اگر پاسخ درست در Metadata، نام فایل یا System Prompt لو رفته باشد، آزمون معتبر نیست. هر تبدیل Dataset باید ثبت شود تا بتوان نشان داد یک نمونه چگونه از منبع خام به ورودی آموزش رسیده است.
Tokenizer و Chat Template؛ خطای پنهان پروژه
کیفیت Tokenizer برای فارسی روی طول توالی و هزینه آموزش اثر دارد. یک جمله فارسی ممکن است در دو مدل تعداد Token بسیار متفاوتی داشته باشد. قبل از انتخاب مدل، توزیع Token Length را روی Dataset واقعی اندازه بگیرید و نمونههایی را که غیرعادی طولانی میشوند بررسی کنید.
Chat Template تعیین میکند نقشها، نشانه آغاز و پایان و جداکننده پیام چگونه Encode شوند. اگر Template آموزش با Template سرویس متفاوت باشد، مدل ممکن است پاسخ را ادامه User بنویسد، Stop Token را رعایت نکند یا نقش System را نادیده بگیرد.
Label Masking نیز مهم است. در SFT چت معمولاً Loss روی پاسخ Assistant محاسبه میشود، نه روی همه Tokenهای User و Padding. تنظیم اشتباه میتواند مدل را به تکرار سؤال تشویق کند یا ظرفیت را صرف حفظ Prompt سازد.
Truncation باید آگاهانه باشد. بریدن انتهای پاسخ، مدل را با نمونه ناقص آموزش میدهد؛ بریدن ابتدای Context نیز شواهد اصلی را حذف میکند. بهتر است نمونه بلند Reject، Chunk یا با Strategy مشخص کوتاه شود و تعداد موارد بریدهشده گزارش شود.
ساخت محیط آموزش روی معماری ARM64
پردازنده GX10 مبتنی بر ARM است. پیش از دانلود مدل بزرگ، سازگاری Image کانتینر، PyTorch، CUDA، Transformers، PEFT، TRL و bitsandbytes را روی ARM64 بررسی کنید. NVIDIA برای DGX Spark Playbookهای PyTorch و NeMo ارائه کرده است، اما ورژنها باید با سیستم GX10 و Driver نصبشده تطبیق داده شوند.
محیط را با Container ورژندار بسازید. ورژن Image، Driver، کتابخانهها، Commit کد، Model Revision و Dataset Hash در هر Run ثبت شوند. عبارت «latest» پخشپذیر نیست و ممکن است هفته بعد Dependency متفاوتی دریافت کند.
Token دسترسی مدلهای Gated را داخل Notebook یا فایل عمومی قرار ندهید. Secret Manager یا Mount محدود استفاده کنید و مجوز مدل را پیش از دانلود بپذیرید. وزن مدل نیز میتواند شرایط توزیع و استفاده تجاری داشته باشد؛ Open Weight الزاماً به معنی مجوز آزاد برای هر کاربرد نیست.
برای تیمی که تجربه محلی محدود دارد، ابتدا یک مدل کوچک و 20 Step آزمایشی اجرا شود. هدف این Run کیفیت نیست؛ باید Download، Tokenizer، Forward، Backward، ذخیره Adapter و Reload را تا انتها تأیید کند. سپس Dataset واقعی و Run طولانی وارد شوند.
پارامترهای LoRA چه معنایی دارند؟
| پارامتر | اثر اصلی | خطای رایج |
|---|---|---|
| Rank یا r | ظرفیت ماتریسهای Adapter | بزرگکردن بدون آزمون |
| Alpha | مقیاس اثر LoRA | تغییر همزمان با چند متغیر |
| Dropout | Regularization | استفاده ثابت برای همه Datasetها |
| Target Modules | لایههای دریافتکننده Adapter | نام ناسازگار با معماری مدل |
| Learning Rate | اندازه گام بهروزرسانی | نرخ بالا و نوسان Loss |
| Sequence Length | حد متن هر نمونه | مصرف حافظه بدون نیاز واقعی |
Rank بالاتر پارامتر قابلآموزش بیشتری میدهد، اما تضمین کیفیت نیست. برای وظیفه باریک، Rank کم ممکن است کافی باشد. بهترین مقدار با چند Run کنترلشده پیدا میشود؛ در هر مقایسه فقط یک یا دو متغیر را تغییر دهید.
Target Module باید با نام لایههای مدل پایه مطابق باشد. ورژنهای مختلف معماری ممکن است نام متفاوتی برای Projectionها داشته باشید. اگر Target اشتباه باشد، Adapter روی لایه نامناسب اعمال میشود یا اصلاً پارامتر قابلآموزش ساخته نمیشود. تعداد Trainable Parameter را پیش از شروع چاپ و بررسی کنید.
Learning Rate مناسب LoRA ممکن است با Full Fine-tuning متفاوت باشد. Loss نزولی بهتنهایی کافی نیست؛ نرخ بالا میتواند سبک Dataset را سریع حفظ کند و توان عمومی مدل را خراب کند. Validation رفتار و Safety باید همراه Loss دیده شوند.
Batch، Gradient Accumulation و Packing
Micro-batch تعداد نمونهای است که در یک Forward جا میگیرد. Gradient Accumulation چند Micro-batch را پیش از Optimizer Step جمع میکند تا Effective Batch بزرگتری ساخته شود. این روش حافظه را کنترل میکند، اما زمان Step و دینامیک آموزش را تغییر میدهد.
Packing چند نمونه کوتاه را در یک Sequence قرار میدهد تا Padding کمتر شود. Attention Mask و مرز نمونه باید درست باشید؛ وگرنه پاسخ یک مکالمه میتواند به نمونه بعدی توجه کند. روی Dataset با طولهای بسیار متفاوت، گزارش Utilization قبل و بعد Packing مفید است.
Gradient Checkpointing Activation کمتری نگه میدارد و بخشی از محاسبات را در Backward دوباره انجام میدهد. این معامله حافظه با زمان است. فعالکردن آن باید در Benchmark End-to-end دیده شود، نه فقط با Peak Memory.
DataLoader نیز میتواند گلوگاه باشد. Tokenization آنلاین، خواندن فایل شبکه و Worker ناسازگار با ARM ممکن است GPU را منتظر نگه دارد. Throughput را با Token/sec، Utilization و زمان Data Loading تفکیک کنید.
Training Run را چگونه مانیتور کنیم؟
حداقل Training Loss، Validation Loss، Learning Rate، Gradient Norm، Token/sec، حافظه و زمان Step ثبت شوند. Spike ناگهانی Gradient ممکن است از نمونه خراب، Sequence بسیار بلند یا Learning Rate نامناسب بیاید. NaN را نباید با ادامه Run نادیده گرفت.
Checkpointهای دورهای اجازه میدهند بهترین مرحله را انتخاب کنید. آخرین Epoch الزاماً بهترین مدل نیست. اگر Validation بدتر و Training بهتر میشود، Overfitting محتمل است. Early Stopping یا کاهش Epoch باید بر معیار وظیفه تکیه کند.
نمونه پاسخ ثابت را در فواصل مشخص اجرا کنید، اما ارزیابی چشمی جای Metric را نمیگیرد. چند Prompt ثابت میتوانند تغییر لحن، طول یا فرمت را زود آشکار کند. برای اجرای خودکار Workflowهای ارزیابی میتوان از Agent استفاده کرد، ولی مقاله ابزارهای ساخت Agent یادآوری میکند که هر گردش کار به Tool و کنترل روشن نیاز دارد.
Run ناموفق نیز دارایی است. Config، خطا و نتیجه را نگه دارید تا تیم همان آزمایش را تکرار نکند. یک Registry ساده با شناسه Run، Dataset، مدل پایه، Adapter و Metric تصمیمگیری را بسیار شفافتر میکند.
ارزیابی مدل فارسی فقط BLEU یا Loss نیست
Metric باید با وظیفه همسو باشد. برای استخراج JSON، Validity، Exact Match و دقت هر فیلد مهماند. برای طبقهبندی، Precision، Recall و Confusion Matrix مناسباند. برای پاسخ آزاد، Rubric انسانی شامل صحت، ارتباط، کاملبودن، لحن و استناد لازم است.
پاسخ فارسی باید از نظر شکل نیز سنجیده شود: نیمفاصله، علائم، عدد، متن ترکیبی و خوانایی راستبهچپ. ارزیاب خودکار ممکن است دو پاسخ معنایی یکسان را متفاوت حساب کند یا پاسخ روان اما غلط را قبول کند. بخشی از Test باید دو بازبین مستقل داشته باشد.
توان عمومی مدل را قبل و بعد مقایسه کنید. Fine-tuning باریک میتواند Catastrophic Forgetting یا تغییر رفتار خارج از دامنه ایجاد کند. مجموعه Regression شامل سؤال عمومی، منطق ساده، امتناع ایمن و چندزبانه کمک میکند این افت دیده شود.
برای دانش بهروز، مدل Fine-tuned را با منبع اشتباه نگیرید. نمونههای آموزشی Snapshot زمانیاند. ابزارهایی مانند NotebookLM روی منابع کاربر تکیه میکند؛ مطلب بهبودهای NotebookLM در کار با منابع تفاوت یک سامانه منبعمحور را نشان میدهد. در محصول سازمانی، Fine-tuning و Retrieval میتوانند مکمل باشید.
Safety، Prompt Injection و داده سمی
Dataset میتواند دستور مخرب، اطلاعات محرمانه یا پاسخ نامناسب داشته باشد. ورودیها را از نظر منبع، مجوز و محتوای حساس بررسی کنید. مکالمهای که اپراتور در آن اطلاعات داخلی را نوشته است، بدون پالایش نباید نمونه آموزشی شود.
Fine-tuning تضمین مقابله با Prompt Injection نیست. مدل باید در Runtime نیز کنترل دسترسی، محدودیت Tool، فیلتر خروجی و جداسازی داده داشته باشد. اگر مدل اجازه ارسال ایمیل یا تغییر رکورد دارد، Policy بیرون از مدل باید هر عملیات را کنترل کند.
برای امتناع ایمن، فقط چند پاسخ «نمیتوانم» کافی نیست. مرز مجاز و غیرمجاز باید با مثالهای نزدیک و Hard Negative آموزش و ارزیابی شود. امتناع بیش از حد نیز کیفیت محصول را خراب میکند؛ مدل نباید سؤال عادی را به دلیل وجود یک واژه حساس رد کند.
Red Team فارسی اهمیت دارد. دورزدنها، غلط املایی، فینگلیش، فاصلهگذاری عجیب و ترکیب فارسی-انگلیسی میتوانند رفتار متفاوتی بسازند. Test ایمنی باید همین تنوع واقعی را پوشش دهد.
LoRA، RAG و Prompt را چگونه ترکیب کنیم؟
یک معماری عملی سه لایه دارد. System Prompt سیاست و نقش جاری را تعریف میکند؛ RAG دانش و سند مجاز را میآورد؛ Adapter رفتار پایدار مانند قالب پاسخ یا اصطلاحات را تنظیم میکند. هر لایه باید مستقل خاموش شود تا اثر آن در A/B Test دیده شود.
اگر پاسخ غلط است، ابتدا منشأ را پیدا کنید. سند درست بازیابی نشده؟ Prompt مبهم است؟ Adapter دانش قدیمی را تحمیل میکند؟ یا مدل پایه توان استدلال ندارد؟ افزودن Epoch بدون تشخیص علت معمولاً مشکل را پنهان میکند.
برای داده خصوصی، اجرای محلی میتواند خروج اطلاعات را کاهش دهد، اما مدیریت دسترسی و Log همچنان ضروری است. مقاله محدودیتهای هوش مصنوعی محلی نشان میدهد Local بودن همیشه مساوی عملکرد یا امنیت کامل نیست؛ فقط مرز مسئولیت را تغییر میدهد.
Adapter را Merge کنیم یا جدا نگه داریم؟
نگهداری Adapter جدا اجازه میدهد یک مدل پایه با چند رفتار سرو شود و Rollback ساده باشد. در مقابل، سرویس باید Base و Adapter سازگار را همزمان Load کند و Mapping ورژنها را بداند. Adapter مدل A نباید روی Revision متفاوت همان خانواده بدون آزمون سوار شود.
Merge میتواند استقرار را ساده کند، اما Artifact کامل بزرگتر میشود و جداسازی تغییر دشوارتر است. پس از Merge باید ارزیابی دوباره انجام شود، بهخصوص اگر Quantization بعدی اعمال میشود. کیفیت ورژن Mergeشده را از روی Adapter اصلی فرض نکنید.
Model Registry باید Base Model ID، Revision، License، Tokenizer، Chat Template، Adapter Config، Dataset Hash، Code Commit و Metricها را ثبت کند. نامی مانند final-v2 کافی نیست. هر Endpoint باید دقیقاً به Artifact قابل بازیابی اشاره کند.
Canary Deployment با درصد کمی از ترافیک و امکان بازگشت مناسب است. Feedback کاربر بهتنهایی Ground Truth نیست؛ Like و Dislike میتوانند سلیقه، سرعت یا محتوا را مخلوط کند. نمونههای شکست باید طبقهبندی و سپس برای Dataset بعدی بررسی شوند.
یک GX10 یا دو دستگاه؟
برای بسیاری از پایلوتهای LoRA و QLoRA یک GX10 نقطه شروع است. دو دستگاه میتوانند با ConnectX-7 و شبکه مناسب آموزش توزیعشده را ممکن کند، اما ظرفیت حافظه آنها به یک حافظه ساده 256GB تبدیل نمیشود. Sharding، Communication و Framework توزیعشده لازم است.
آموزش دوگرهای هزینه هماهنگی دارد. اگر Dataset کوچک یا مدل سبک باشد، Overhead ارتباط ممکن است سود را کاهش دهد. پیش از Scale-out، گلوگاه Run تکگرهای را اندازه بگیرید. گاهی بهینهسازی Tokenization یا Packing ارزش بیشتری دارد.
زیرساخت ابری برای Runهای موقت بسیار بزرگ یا تیم بدون عملیات محلی میتواند مناسبتر باشد. در مقابل، GX10 برای تکرارهای پیوسته، داده حساس و دسترسی رومیزی جذاب است. مقیاس پروژههای دیتاسنتر هوش مصنوعی متا با هدف یک ایستگاه توسعه محلی متفاوت است.
هزینه کل شامل برق، زمان مهندس، ذخیرهسازی، Backup، مدل، نظارت و فرصت ازدسترفته است. قراردادهای بزرگ مانند همکاری OpenAI و Oracle برای دیتاسنتر نشان میدهند آموزش در مقیاس Frontier مسئله دیگری است؛ Fine-tuning سازمانی نباید با پیشآموزش مدل مرزی مقایسه شود.
پایلوت 30 روزه فاینتیون فارسی
- روز 1 تا 5: یک وظیفه محدود، مدل پایه دارای مجوز و 200 نمونه ارزیابی انتخاب کنید. Baseline با Prompt و RAG را ثبت کنید.
- روز 6 تا 10: Guideline Dataset، Normalization، Schema و Split بدون Leakage را بسازید. 500 تا 2000 نمونه باکیفیت اولیه کافی است تا فرضیه آزمایش شود؛ عدد نهایی به وظیفه بستگی دارد.
- روز 11 تا 15: محیط ARM64 و Container را با Run بیستمرحلهای تأیید کنید. ذخیره و Reload Adapter را آزمایش کنید.
- روز 16 تا 20: سه Run کنترلشده با LoRA یا QLoRA اجرا کنید. Rank، Learning Rate یا Sequence Length را یکییکی تغییر دهید.
- روز 21 تا 25: ارزیابی وظیفه، فارسی، Regression و Safety را انجام دهید. نتیجه را با Baseline و هزینه مقایسه کنید.
- روز 26 تا 30: Adapter منتخب را پشت Endpoint آزمایشی قرار دهید، Canary و Rollback بسازید و تصمیم Go، اصلاح یا توقف را مستند کنید.
پایلوت باید یک سؤال اقتصادی را پاسخ دهد: آیا Fine-tuning نسبت به Prompt یا RAG نرخ خطا را به اندازهای کاهش میدهد که هزینه ساخت و نگهداری آن توجیه شود؟ برای دید فرایندی، مقاله اتوماسیون سازمانی با هوش مصنوعی یادآوری میکند که مدل فقط یک جزء از گردش کار است.
خطاهای رایج در Fine-tuning مدل فارسی
- آموزش پیش از ساخت Baseline با Prompt و RAG؛
- انتخاب مدل فقط بر اساس تعداد پارامتر و نادیدهگرفتن Tokenizer فارسی؛
- کپی داده مشابه در Train و Test و گزارش امتیاز غیرواقعی؛
- استفاده از Chat Template متفاوت در آموزش و سرویس؛
- محاسبه Loss روی Padding یا پیام User بدون قصد روشن؛
- افزایش Rank، Epoch و Learning Rate بهصورت همزمان؛
- تفسیر Loss پایین بهعنوان صحت و ایمنی کامل؛
- ثبتنکردن ورژن مدل، Dataset، Container و Adapter؛
- آموزش اطلاعات متغیر و انتظار بهروزرسانی خودکار دانش؛
- استقرار مستقیم ورژن Mergeشده بدون Regression Test؛
- فرض اینکه 128GB حافظه همگی برای وزن مدل آزاد است؛
- نادیدهگرفتن مجوز مدل و اطلاعات شخصی Dataset.
چکلیست پیش از شروع آموزش
- وظیفه و معیار موفقیت در سطح خروجی تعریف شده است.
- Prompt و RAG Baseline با همان Test ثبت شدهاند.
- مجوز مدل و داده برای استفاده موردنظر بررسی شده است.
- Tokenizer و طول توزیع Token روی فارسی سنجیده شدهاند.
- Chat Template آموزش و سرویس یکسان است.
- Train، Validation و Test بدون پرونده یا Template مشترکاند.
- Environment روی ARM64 با Run کوتاه تأیید شده است.
- Peak Memory با حاشیه امن اندازهگیری میشود.
- Metric وظیفه، فارسی، Regression و Safety آماده است.
- Adapter، Dataset و Config شناسه ورژن دارند.
- Canary، Monitoring و Rollback پیش از Production طراحی شدهاند.
پرسشهای متداول
آیا GX10 میتواند مدل 70B را Fine-tune کند؟
NVIDIA برای سختافزار DGX Spark مبتنی بر GB10 نمونههای LoRA و QLoRA مدل 70B منتشر کرده است و QLoRA برای کاهش حافظه طراحی شده است. بااینحال، سازگاری دقیق مدل، طول توالی، ورژن نرمافزار و زمان آموزش باید روی GX10 شما آزمایش شود؛ قابلیت Load شدن به معنی مناسببودن سرعت یا کیفیت نیست.
LoRA بهتر است یا QLoRA؟
اگر حافظه کافی و مسیر نرمافزاری سادهتر میخواهید، LoRA نقطه شروع خوبی است. اگر مدل پایه در Precision بالاتر جا نمیشود، QLoRA مصرف حافظه را کاهش میدهد. تصمیم نهایی باید با کیفیت، سرعت و پایداری همان Workload گرفته شود.
چند نمونه فارسی برای Fine-tuning لازم است؟
عدد ثابتی وجود ندارد. وظیفه باریک با نمونههای دقیق ممکن است از چندصد یا چندهزار نمونه سود ببرد، اما پوشش، تنوع و کیفیت مهمتر از عدد خام است. Learning Curve با چند اندازه Dataset بهترین پاسخ را میدهد.
آیا Fine-tuning دانش جدید را به مدل اضافه میکند؟
ممکن است الگوها و برخی حقایق را در وزنها جذب کند، اما برای دانش متغیر، قابل استناد و قابل حذف گزینه مطمئنی نیست. RAG یا Tool Access معمولاً مدیریتپذیرتر است و Fine-tuning بهتر است رفتار استفاده از آن دانش را تنظیم کند.
آیا Adapter کوچک را میتوان روی هر ورژن مدل اجرا کرد؟
خیر. Adapter به معماری، نام لایهها و معمولاً Revision مدل پایه وابسته است. Base، Tokenizer و Config باید همان ورژن تأییدشده باشید و هر تغییر با Regression Test سنجیده شود.
آیا اجرای محلی داده را کاملاً امن میکند؟
خیر. اجرای محلی خروج داده به سرویس بیرونی را کاهش میدهد، اما کنترل دسترسی، رمزگذاری، Secret، Log، Backup، Patch و حذف داده همچنان مسئولیت سازمان است.
کلام آخر
فاینتیون مدل فارسی با ASUS Ascent GX10 زمانی نتیجه میدهد که مسئله رفتاری مشخص، Dataset پالایششده و Test مستقل داشته باشید. LoRA و QLoRA هزینه آموزش را نسبت به تغییر همه وزنها کاهش میدهند، ولی جای انتخاب درست مدل، Chat Template، کنترل Leakage و ارزیابی انسانی را نمیگیرند.
حافظه یکپارچه 128GB و اکوسیستم NVIDIA به GX10 امکان میدهند Runهای Fine-tuning محلی جدی را میزبانی کند. بااینحال، ظرفیت واقعی به مدل، Precision، Sequence Length، Batch و سازگاری ARM64 وابسته است. از مدل کوچک و Run کوتاه شروع کنید، اثر هر تغییر را جدا بسنجید و فقط Adapterی را وارد سرویس کنید که در وظیفه، فارسی، Regression و Safety از Baseline بهتر باشد.
پاسخگوی سوالات شما هستیم
دیدگاهی وجود ندارد!