


آنچه خواهید خواند
- چهار روش نگهداری چه تفاوتی دارند؟
- معماری واقعی از حسگر تا دستور کار تعمیرات
- از یک ماشین و یک Failure Mode شروع کنید
- انتخاب حسگر؛ لرزش، صدا، دما یا جریان؟
- نمونهبرداری و همگامسازی قبل از هوش مصنوعی
- پردازش سیگنال؛ از Waveform تا Feature
- Dataset زمانی را بدون نشت و سوگیری بسازید
- کدام مدل برای نگهداری پیشبینانه مناسب است؟
- GX10 در آموزش و اجرای مدل چه نقشی دارد؟
- ادغام چند حسگر و مدل چندوجهی
- Threshold و هشدار کاذب را عملیاتی طراحی کنید
- معیار پذیرش را پیش از دیدن نتیجه تعیین کنید
- اتصال به CMMS؛ حلقه بازخورد را نبندید
- امنیت OT و مدیریت خود GX10
- Drift؛ وقتی ماشین یا حسگر تغییر میکند
- یک GX10 چند ماشین را پوشش میدهد؟
- پایلوت 30 روزه پیشنهادی
- اشتباهات رایج پروژههای تعمیرات هوشمند
- چکلیست پیش از بهرهبرداری
- پرسشهای متداول
- کلام آخر؛ هدف پیشبینی نیست، اقدام بهموقع است
نگهداری پیش بینانه با ASUS Ascent GX10 چگونه اجرا میشود؟
نگهداری پیش بینانه با ASUS Ascent GX10 یعنی داده لرزش، صدا، دما، جریان و وضعیت کاری تجهیزات را نزدیک کارخانه جمعآوری کنیم، الگوی سالم هر ماشین را یاد بگیریم و تغییر معنادار را پیش از خرابی جدی به تیم تعمیرات نشان دهیم. GX10 میتواند آمادهسازی داده، آموزش و استنتاج مدل، تحلیل چند حسگر و دستیار فنی را اجرا کند؛ اما خودش حسگر صنعتی، سامانه مانیتورینگ وضعیت یا نرمافزار CMMS آماده نیست.
نتیجه معتبر یک «تاریخ دقیق خرابی» جادویی نیست. در بسیاری از پروژههای واقعی، خروجی نخست باید سطح سلامت، نوع ناهنجاری، شدت، شواهد و پیشنهاد بازرسی باشد. تخمین Remaining Useful Life یا RUL فقط وقتی قابل دفاع است که تاریخچه کافی از خرابی، تعمیر و شرایط بهرهبرداری وجود داشته باشد.
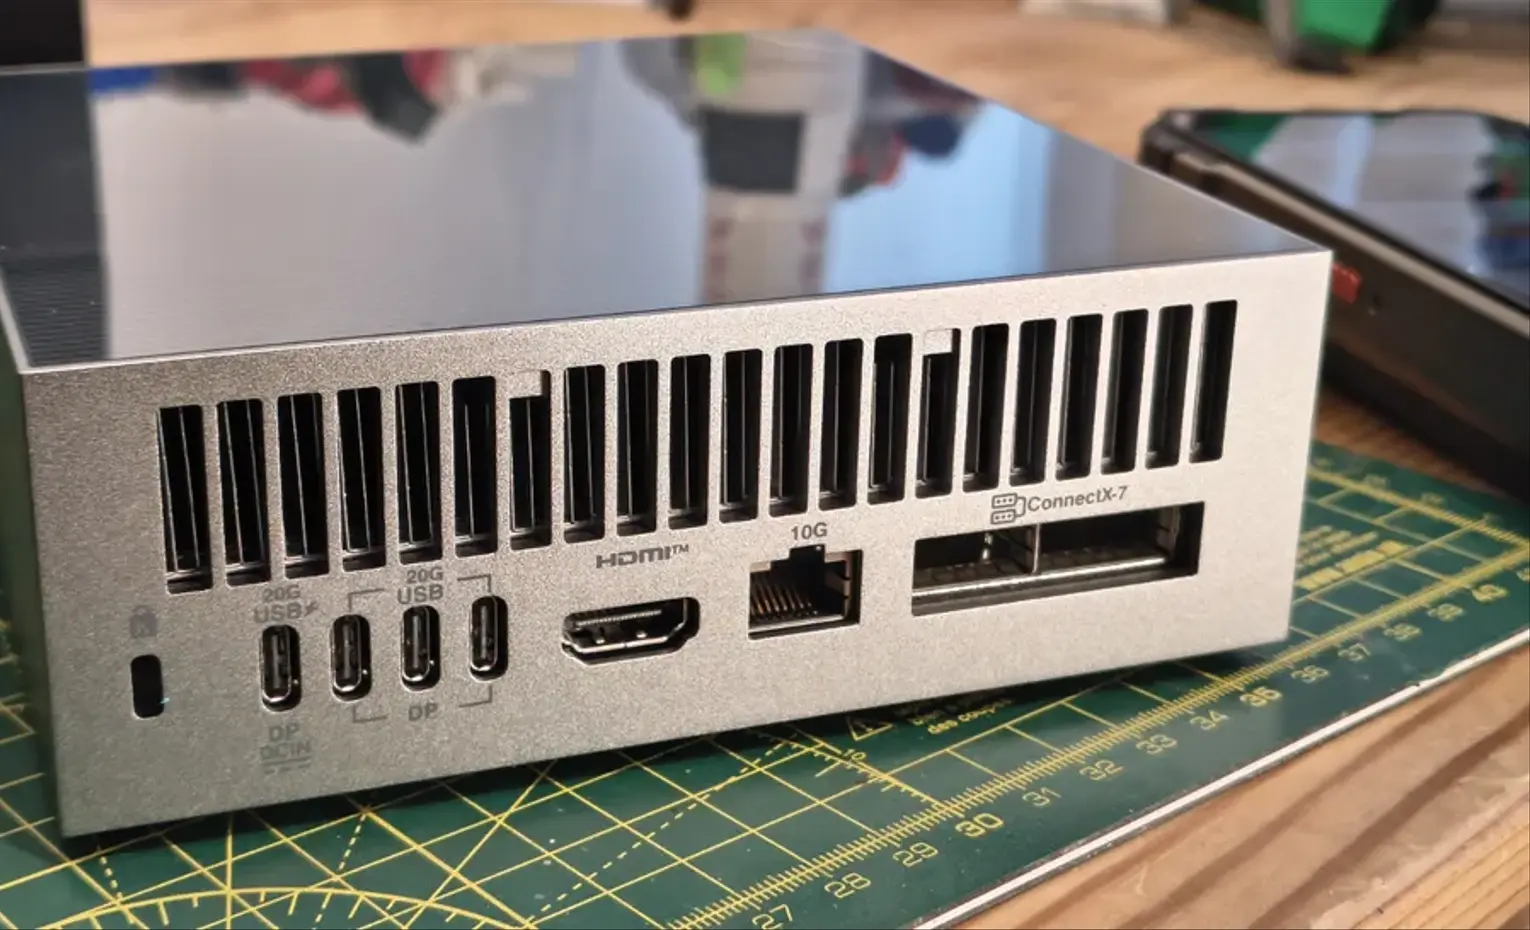
ورک استیشن هوش مصنوعی ایسوس مدل Ascent GX10 از پردازنده NVIDIA GB10 Grace Blackwell، حافظه یکپارچه 128GB LPDDR5x، شبکه 10GbE و ConnectX-7 استفاده میکند. این مشخصات برای آزمایش همزمان Pipeline سیگنال، مدل زمانی و دستیار زبانی مناسباند، ولی تعداد ماشین و نرخ نمونه قابل پشتیبانی باید با Benchmark همان سامانه تعیین شود. برای شناخت بستر، ابتدا بررسی سوپر کامپیوتر ASUS Ascent GX10 و توضیح پردازنده GB10 Grace Blackwell را ببینید.
چهار روش نگهداری چه تفاوتی دارند؟
| روش | زمان اقدام | مبنای تصمیم | محدودیت اصلی |
|---|---|---|---|
| واکنشی | پس از خرابی | توقف یا ازکارافتادن | توقف ناخواسته و خسارت ثانویه |
| پیشگیرانه | طبق تقویم یا ساعت کار | برنامه ثابت | تعویض زودهنگام یا دیرهنگام قطعه |
| مبتنی بر وضعیت | پس از عبور شاخص از حد | Threshold لرزش، دما یا روغن | قانون ثابت همه الگوها را نمیبیند |
| پیشبینانه | پیش از خرابی محتمل | روند، ناهنجاری و مدل داده | به داده، فرایند و بازخورد معتبر نیاز دارد |
این روشها رقیب مطلق یکدیگر نیستند. یک تجهیز بحرانی میتواند بازدید ایمنی زمانبندیشده، پایش وضعیت آنلاین و مدل پیشبینانه را همزمان داشته باشد. AI نباید الزام سازنده، قانون ایمنی یا بازرسی دورهای اجباری را حذف کند.
ارزش اصلی مدل در اولویتبندی است. تیم تعمیرات بهجای واکنش به صدها نمودار، فهرستی از داراییهای مشکوک با دلیل دریافت میکند: افزایش انرژی یک باند فرکانسی، رشد دمای یاتاقان، تغییر صدای گیربکس یا ترکیب چند نشانه. این فهرست باید کار بازرس را دقیقتر کند، نه اینکه قضاوت فنی را حذف کند.
معماری واقعی از حسگر تا دستور کار تعمیرات
| لایه | کار اصلی | خروجی | ریسک رایج |
|---|---|---|---|
| حسگر | ثبت لرزش، صدا، دما، جریان یا RPM | سیگنال دارای زمان | نصب یا کالیبراسیون نادرست |
| DAQ و Gateway | نمونهبرداری، Buffer و ارسال امن | بسته داده همگام | افت نمونه و Clock نامعتبر |
| ذخیرهسازی | ثبت Raw، Feature و Metadata | تاریخچه قابل ردیابی | داده بدون شناسه ماشین و بار |
| پردازش سیگنال | فیلتر، Window، FFT و Feature | نمایش زمانی و فرکانسی | حذف نشانه خرابی در Preprocess |
| مدل | Baseline، Anomaly و تشخیص حالت | Score، کلاس و Confidence | آموزش روی شرایط محدود |
| منطق هشدار | ترکیب شدت، تداوم و بحرانیبودن | هشدار قابل اقدام | هشدار کاذب فراوان |
| CMMS یا EAM | ثبت بازرسی، نتیجه و تعمیر | گردش کار و Feedback | ساخت خودکار تیکت بدون زمینه |
GX10 معمولاً در بخش پردازش، مدل، ذخیره Feature و رابط تحلیل قرار میگیرد. اتصال مستقیم هر حسگر به دستگاه انتخاب حرفهای نیست؛ Transmitter صنعتی، DAQ، PLC یا Gateway باید سیگنال را با نرخ و پروتکل مطمئن تحویل دهد. مسیر کنترل ایمنی نیز باید مستقل از مدل باقی بماند.
همان منطق Edge که در پردازش محلی Anker MindBase دیده میشود، در کارخانه با سختگیری بیشتری اجرا میشود: داده نزدیک منبع تحلیل میماند و فقط رخداد یا Feature لازم منتقل میشود. تفاوت مهم، نیاز صنعتی به Time Sync، دسترسپذیری، ثبت رخداد و امنیت OT است.
از یک ماشین و یک Failure Mode شروع کنید
پروژهای با عبارت «خرابی کارخانه را پیشبینی کنیم» قابل اجرا نیست. ابتدا یک دارایی با اثر مالی روشن انتخاب کنید: موتور فن کوره، پمپ سیرکولاسیون، گیربکس نوار نقاله یا کمپرسور. سپس یک Failure Mode مشخص مانند نابالانسی، ناهممحوری، خرابی یاتاقان، کاویتاسیون یا شلشدگی مکانیکی را هدف بگیرید.
برای انتخاب پایلوت، چهار سؤال مهماند: خرابی چند بار رخ میدهد؟ علامت قابل اندازهگیری پیش از خرابی چیست؟ تیم پس از هشدار چه اقدامی میتواند انجام دهد؟ و هزینه یک هشدار اشتباه چقدر است؟ تجهیزی که هیچ خرابی ثبتشده، هیچ فرصت اقدام و هیچ مالک عملیاتی ندارد، شروع خوبی نیست.
Criticality دارایی را جدا ثبت کنید. یک پمپ رزرو با یک توربین بدون Redundancy وزن یکسان ندارد. مدل ممکن است Score مشابهی بدهد، اما منطق هشدار باید اثر ایمنی، توقف تولید، کیفیت محصول، زمان تأمین قطعه و وجود تجهیز جایگزین را لحاظ کند.
انتخاب حسگر؛ لرزش، صدا، دما یا جریان؟
شتابسنج لرزش برای تجهیزات دوار رایج است، زیرا تغییرات مکانیکی میتوانند در Waveform و طیف فرکانسی دیده شوند. جهت نصب، محل، اتصال محکم، Range و Sampling Rate روی نتیجه اثر دارند. جابهجایی حسگر چند سانتیمتر یا نصب شل میتواند Baseline را عوض کند.
حسگر دما روند آهستهتر را نشان میدهد و برای یاتاقان، موتور، تابلو یا سیال مفید است؛ اما افزایش دما ممکن است دیرتر از تغییر لرزش رخ دهد. صدا و Ultrasound میتوانند نشتی، اصطکاک یا تغییر عملکرد را آشکار کند، ولی نویز محیط، فاصله میکروفون و بازتاب سالن باید کنترل شوند.
جریان موتور و توان میتوانند بار و رفتار الکتریکی را نشان دهند. RPM، Load، Valve State، Recipe و حالت Start/Stop نیز حسگر خرابی نیستند، اما زمینهای حیاتی برای تفسیر سیگنالاند. مقایسه لرزش موتور در بیباری با بار کامل میتواند هشدار بیمعنا بسازد.
فناوری MEMS فقط به صوت مصرفی محدود نیست و اساس بسیاری از اندازهگیریهای کوچک را شکل میدهد. مقاله فناوری حسگرهای لرزشی MEMS زمینه خوبی درباره تبدیل ارتعاش به داده دیجیتال میدهد، هرچند انتخاب Sensor صنعتی نیازمند مشخصات و استاندارد همان محیط است.
نمونهبرداری و همگامسازی قبل از هوش مصنوعی
نرخ نمونه باید با فرکانس پدیده هدف تناسب داشته باشد. اگر Sampling پایین باشد، مؤلفههای سریع از دست میروند یا به شکل اشتباه دیده میشوند. اگر بیدلیل بسیار بالا باشد، حجم انتقال و ذخیرهسازی رشد میکند. Anti-aliasing، Range سنسور و رزولوشن مبدل بخشی از طراحیاند، نه جزئیات فرعی.
سیگنال پیوسته معمولاً به Windowهای کوتاه تقسیم میشود. طول Window، میزان Overlap و شرایط Trigger روی تشخیص اثر دارند. Window بسیار کوتاه الگوی کامل را نمیبیند و Window بسیار بلند رخداد کوتاه را در میانگین پنهان میکند. انتخاب باید با سرعت ماشین و نوع خرابی آزمایش شود.
Clock حسگر، Gateway، PLC و GX10 باید همگام باشد. بدون زمان معتبر نمیتوان رشد لرزش را با افزایش بار، تعمیر قبلی یا توقف خط تطبیق داد. Packet Loss، Buffer Overflow و Gap داده باید علامتگذاری شوند؛ پرکردن کورکورانه داده گمشده میتواند ناهنجاری مصنوعی بسازد.
پردازش سیگنال؛ از Waveform تا Feature
اولین مرحله همیشه مدل عمیق نیست. RMS، Peak، Peak-to-Peak، Crest Factor، Kurtosis، انرژی باند و روند دما میتوانند Baseline ساده و قابل توضیح بسازند. نمایش Time Domain برای ضربه و رخداد گذرا مفید است و FFT انرژی سیگنال را در مؤلفههای فرکانسی نشان میدهد.
در ماشین با سرعت متغیر، طیف بدون RPM ممکن است گمراهکنده باشد. Order Tracking یا نرمالسازی نسبت به سرعت میتواند الگو را با دور ماشین هماهنگ کند. برای یاتاقان یا گیربکس، Feature مناسب به هندسه و Failure Mode بستگی دارد؛ یک Feature عمومی برای همه تجهیزات کافی نیست.
پیشپردازش باید ورژندار باشد. تغییر Filter، Window، Scaling یا واحد اندازهگیری بدون ثبت ورژن میتواند Distribution ورودی را عوض کند. Raw Data منتخب را نگه دارید تا اگر Feature Pipeline اشتباه بود، امکان بازسازی وجود داشته باشد.
GPU زمانی ارزش بیشتری پیدا میکند که تعداد سیگنال، طول داده یا تعداد آزمایشها زیاد باشد. ابزارهایی مانند cuFFT و RAPIDS میتوانند پردازش موازی و Data Preparation را شتاب دهند، اما Dataset کوچک و یک ماشین ممکن است با CPU نیز بهخوبی اجرا شود. برچسب AI روی سختافزار جای Benchmark را نمیگیرد؛ این نکته در مطلب فریب بازاریابی AI در پردازندهها نیز بررسی شده است.
Dataset زمانی را بدون نشت و سوگیری بسازید
داده نگهداری یک جدول تصادفی از نمونههای مستقل نیست. Windowهای پشتسرهم یک موتور بسیار شبیهاند و اگر بخشی از همان ساعت در Train و بخشی در Test قرار گیرد، مدل شرایط ماشین را حفظ میکند و دقتی غیرواقعی نشان میدهد. جداسازی باید بر اساس بازه زمانی آینده، Asset یا دوره پیش و پس از تعمیر انجام شود.
برای آزمون تعمیم، چند سطح لازم است. Test زمانی میسنجد مدل روی روزهای بعد چگونه کار میکند؛ Test بیندارایی نشان میدهد آیا مدل آموخته یک موتور روی موتور مشابه دیگر قابل استفاده است؛ و Test پس از تعمیر بررسی میکند Baseline جدید چگونه رفتار میکند. نتیجه این سه آزمون ممکن است متفاوت باشد و نباید در یک Accuracy کلی مخفی شود.
گزارش تعمیرات معمولاً ناقص و دارای تأخیر است. زمان ثبت Work Order لزوماً زمان آغاز خرابی نیست و زمان تعویض قطعه نیز اثبات نمیکند قطعه واقعاً خراب بوده است. Labelها بهتر است درجه اعتبار داشته باشید: «تأیید با بازرسی»، «تأیید با قطعه تعویضشده»، «گزارش اپراتور» و «حدس مدل». فقط گروههای معتبر برای آموزش قطعی استفاده شوند.
داده سالم نیز باید متنوع باشد. Start-up، Shutdown، بار کم، بار زیاد، Recipeهای مختلف، فصل گرم و سرد و تغییر شیفت ممکن است الگوهای سالم متفاوتی بسازند. اگر مدل فقط یک هفته آرام را ببیند، هر وضعیت قانونی تازه را ناهنجاری اعلام میکند. نگهداری Dataset باید برنامه مستمر باشد، نه یک استخراج یکباره پیش از راهاندازی.
عدم توازن طبیعی است؛ خرابی واقعی کم و داده سالم بسیار زیاد است. Accuracy در چنین Datasetی میتواند فریبنده باشد. Sampling، وزندهی و انتخاب Metric باید مطابق هزینه خطا انجام شوند. برای ارزیابی Lead Time نیز باید مشخص شود نخستین هشدار پایدار چند ساعت یا چند روز پیش از تأیید خرابی رخ داده است، نه اینکه همه Windowهای یک خرابی جداگانه موفقیت حساب شوند.
کدام مدل برای نگهداری پیشبینانه مناسب است؟
| هدف | روش آغازین | داده لازم | خروجی |
|---|---|---|---|
| عبور از حد | Rule و Statistical Threshold | Baseline سالم و حد مهندسی | هشدار شفاف |
| تشخیص ناهنجاری | Isolation Forest یا Autoencoder | داده سالم متنوع | Anomaly Score |
| تشخیص نوع خرابی | XGBoost، 1D CNN یا مدل طیفی | نمونه برچسبدار هر خرابی | کلاس و Confidence |
| پیشبینی روند | Forecasting چندمتغیره | تاریخچه منظم و زمینه کاری | روند آینده |
| تخمین RUL | Survival یا Sequence Model | چرخه تا خرابی و Censoring | بازه عمر باقیمانده |
اگر خرابی واقعی کم است، Anomaly Detection روی داده سالم شروع منطقیتری است. مدل میآموزد رفتار عادی در بارها و سرعتهای مختلف چگونه است و انحراف را Score میکند. اما ناهنجاری الزاماً خرابی نیست؛ تغییر محصول، تعمیر، Sensor Drift یا وضعیت عملیاتی تازه نیز میتواند Score را بالا ببرد.
Classification زمانی مناسب است که برای هر Failure Mode نمونه معتبر وجود داشته باشد. Label باید از گزارش تعمیر، بازرسی یا قطعه تعویضشده بیاید، نه حدس تحلیلگر. عبارتهایی مانند «صدا بد بود» بدون علت تأییدشده برای آموزش کلاس یاتاقان کافی نیستند.
RUL سختترین خروجی است. ماشینهایی که هنوز خراب نشدهاند داده Censored دارند و نباید مانند خرابی کامل تفسیر شوند. بهتر است ابتدا Health Index و Early Warning معتبر بسازید و فقط پس از جمعشدن چرخههای واقعی به سراغ تخمین عمر بروید.
GX10 در آموزش و اجرای مدل چه نقشی دارد؟
حافظه یکپارچه 128GB اجازه میدهد داده زمانی، Spectrogram، مدلهای چندحسگری و ابزارهای تحلیلی در یک محیط توسعه قرار گیرند. Jupyter، PyTorch، RAPIDS و کتابخانههای CUDA میتوانند برای Exploration و آموزش استفاده شوند. بااینحال، توان اعلامشده FP4 معیار مستقیمی برای FFT، XGBoost یا یک مدل 1D کوچک نیست.
یک نمونه صنعتی منتشرشده توسط NVIDIA نشان میدهد تیم Tractian از DGX Spark برای Prototype محلی مدلها و Agentها استفاده کرده و آموزش بزرگ را روی کلاسترهای دیتاسنتری گسترش داده است. همین مرزبندی برای GX10 منطقی است: توسعه، Fine-tuning و استنتاج محدود در محل؛ آموزش بسیار بزرگ در زیرساخت مقیاسپذیر.
معماری ARM64 دستگاه باید از ابتدا بررسی شود. Driver مربوط به DAQ، SDK فروشنده حسگر، ODBC Connector، Agent امنیتی یا کتابخانه قدیمی ممکن است فقط x86_64 باشد. موفقیت اجرای PyTorch ثابت نمیکند کل OT Stack سازگار است. چالش اجرای محلی و وابستگی نرمافزار در مقاله محدودیتهای هوش مصنوعی محلی نیز با مقیاسی متفاوت توضیح داده شده است.
ادغام چند حسگر و مدل چندوجهی
ترکیب لرزش، دما، Ultrasound و RPM میتواند Context بهتری از یک حسگر بدهد. اما Fusion فقط کنارهمگذاشتن ستونها نیست. نرخ نمونه متفاوت، تأخیر Sensor، داده گمشده و واحدها باید هماهنگ شوند. ممکن است لرزش با هزاران نمونه در ثانیه و دما هر چند دقیقه ثبت شود.
سه الگو رایجاند: Early Fusion ویژگیهای همه حسگرها را پیش از مدل ترکیب میکند؛ Late Fusion Score چند مدل را در منطق تصمیم ادغام میکند؛ و Hybrid بخشی از Featureها را مشترک میسازد. Late Fusion برای عیبیابی عملی شفافتر است، زیرا میتوان دید کدام حسگر هشدار را ساخته است.
صدا و تصویر نیز میتوانند نقش تأیید داشته باشید. پس از هشدار لرزش، دوربین حرارتی یا ضبط کوتاه صدا به بازرس شواهد بیشتری میدهد. اینجا مقاله هوش مصنوعی فیزیکی در محیط واقعی یادآوری میکند که مدل باید با تغییرات جهان فیزیکی و محدودیت Sensor کنار بیاید.
Threshold و هشدار کاذب را عملیاتی طراحی کنید
یک Anomaly Score بهتنهایی هشدار نیست. منطق تصمیم باید شدت، مدت، تکرار، روند، Criticality و حالت کاری را بسنجد. عبور یک Window شاید نویز باشد؛ افزایش پیوسته در چند ساعت همراه با رشد دما اهمیت بیشتری دارد.
هشدارها را میتوان در سه سطح ساخت: Observe برای پایش، Inspect برای بازرسی در فرصت نزدیک و Urgent برای اقدام سریع طبق دستورالعمل انسانی. مدل نباید مستقیم دستگاه بحرانی را خاموش کند، مگر سامانه کنترل و ایمنی مستقل آن تصمیم را تأیید کند.
هشدار کاذب زیاد اعتماد تعمیرکار را از بین میبرد. علاوه بر Precision و Recall، Alert per Asset per Week، زمان تا تأیید، درصد هشدار قابل اقدام و Downtime جلوگیریشده را اندازه بگیرید. Threshold یکسان برای همه ماشینها معمولاً مناسب نیست؛ Baseline و بحرانیبودن متفاوتاند.
معیار پذیرش را پیش از دیدن نتیجه تعیین کنید
پیش از آموزش، تیم عملیات باید بنویسد چه نتیجهای ارزش ادامه دارد. نمونه معیارها شامل حداقل Lead Time برای تهیه قطعه، سقف هشدار کاذب در هفته، درصد داراییهای دارای پوشش، زمان پاسخ Pipeline، نرخ Data Gap و سهم هشدارهای تأییدشدهاند. انتخاب Threshold پس از دیدن Test برای رسیدن به عدد دلخواه، ارزیابی را آلوده میکند.
معیار تجاری را نیز جدا نگه دارید: ساعت توقف جلوگیریشده، کاهش تعمیر اضطراری، هزینه بازرسی اضافه، کاهش موجودی قطعه و زمان صرفشده تکنسین. ممکن است مدل از نظر آماری بهتر شود ولی به دلیل هشدار دیرهنگام یا نبود قطعه یدکی هیچ ارزش عملی نسازد. موفقیت فنی و موفقیت عملیاتی باید هر دو گزارش شوند.
برای دارایی بحرانی، فقط میانگین کافی نیست. بدترین تأخیر، شکست در زمان قطع شبکه و رفتار مدل هنگام Sensor Fault باید تست شوند. مدل جدید نیز باید در Shadow Mode کنار ورژن قبلی اجرا شود تا Regression آشکار شود. Rollout مرحلهای از یک Asset به یک Line و سپس چند سایت، ریسک گسترش را کاهش میدهد.
اتصال به CMMS؛ حلقه بازخورد را نبندید
خروجی باید به زبان تعمیرات تبدیل شود: شناسه دارایی، زمان، وضعیت کاری، Sensor مؤثر، نمودار قبل و بعد، شدت، پیشنهاد بازرسی و لینک داده خام. فقط ارسال عدد 0.87 یا پیام «Anomaly» برای تکنسین کافی نیست.
در مرحله پایلوت بهتر است سیستم تیکت پیشنهادی بسازد و انسان آن را تأیید کند. پس از بازرسی، نتیجه در CMMS ثبت شود: خرابی تأیید شد، Sensor مشکل داشت، تغییر بار بود یا هشدار بیاهمیت بود. این Feedback ارزشمندترین Label برای ورژن بعدی مدل است.
دستیار زبانی محلی میتواند Manual، تاریخچه Work Order و قطعات یدکی را بازیابی کند و کنار هشدار خلاصهای بسازد. اما توصیه باید منبع، ورژن سند و سطح اطمینان داشته باشد. ابزارهای ساخت Agent هوش مصنوعی زمانی مفیدند که هر Tool Call محدود، ثبتشده و قابل تأیید باشد.
امنیت OT و مدیریت خود GX10
شبکه حسگر و PLC را مستقیم در اختیار Notebook یا سرویس آزمایشی نگذارید. Gateway، Broker، DMZ صنعتی یا API فقطخواندنی میتواند مرز ایجاد کند. حسابها، Certificate، Firewall، Patch و Secretها باید زیر سیاست IT و OT باشید.
GX10 نیز یک دارایی سازمانی است: Inventory، ورژن Firmware و Driver، Backup، لاگ، پنجره بهروزرسانی و برنامه Incident Response نیاز دارد. مستندات NVIDIA برای سیستمهای مبتنی بر DGX Spark توصیه میکند دستگاه مانند Endpoint مدیریتشده با رویکرد Appliance دیده شود، نه یک کامپیوتر شخصی رهاشده.
اجرای محلی خروج داده را کاهش میدهد، اما امنیت را خودکار تضمین نمیکند. Dashboard بدون احراز هویت، Bucket عمومی، Backup رمزنگارینشده یا حساب مشترک همچنان خطر است. مزیت Edge در کنار کنترل دسترسی و Audit معنا پیدا میکند.
Drift؛ وقتی ماشین یا حسگر تغییر میکند
تعویض یاتاقان، تعمیر اساسی، تغییر Foundation، جابهجایی Sensor، Firmware جدید، تغییر تأمینکنده یا Recipe تازه Baseline را عوض میکند. این تغییر لزوماً خرابی مدل نیست؛ باید Event تعمیر و Configuration ماشین کنار داده ثبت شود.
Sensor Drift نیز مهم است. رشد آهسته Bias یا کاهش حساسیت میتواند به شکل تغییر سلامت ماشین دیده شود. Calibration، Reference Measurement و مقایسه چند Sensor به تشخیص کمک میکند. مدل باید کیفیت داده را پیش از سلامت تجهیز ارزیابی کند.
پس از تعمیر، مدل نباید کورکورانه همان Baseline قبلی را ادامه دهد. یک دوره Stabilization تعریف و ورژن Baseline جدید ساخته شود. بازآموزی فقط با داده تازه کافی نیست؛ Dataset Acceptance، Regression Test و امکان Rollback لازماند.
یک GX10 چند ماشین را پوشش میدهد؟
پاسخ ثابت وجود ندارد. نرخ نمونه، تعداد کانال، Window، FFT، Model، Retention، Dashboard و Latency ظرفیت را تعیین میکند. صد Sensor دما با نمونه دقیقهای شبیه دهها کانال لرزش پرسرعت نیست. ظرفیت باید انتهابهانتها سنجیده شود.
- Baseline تکدارایی: Ingest، Feature، Inference و ذخیره را جدا اندازه بگیرید.
- بار پلکانی: تعداد Stream و نرخ واقعی را مرحلهای زیاد کنید.
- صدک 95 و 99: میانگین Latency نوسان و Queue را پنهان میکند.
- آزمون چندروزه: Memory Leak، رشد Storage و قطع شبکه را آشکار کنید.
- Failover: مشخص کنید هنگام توقف GX10، Gateway چه دادهای را Buffer میکند.
برای Fleet بزرگ، معماری سلسلهمراتبی بهتر است: Feature ساده و Rule نزدیک حسگر، تحلیل چندمتغیره روی GX10 و آموزش سنگین در دیتاسنتر. گزارش مقیاس دیتاسنتر هوش مصنوعی Meta نشان میدهد یک ایستگاه رومیزی و زیرساخت آموزش گسترده مسائل متفاوتیاند.
پایلوت 30 روزه پیشنهادی
هفته اول؛ مسئله و Instrumentation: یک دارایی، یک Failure Mode و یک اقدام پس از هشدار تعریف کنید. Sensor، محل نصب، واحد، Sampling و Metadata ثبت شوند. تاریخچه Work Order و خرابی پاکسازی شود.
هفته دوم؛ Baseline و Feature: شرایط سالم در بارها و سرعتهای مختلف جمعآوری شود. Rule مهندسی و مدل ساده ساخته شوند. داده گمشده، Sensor Quality و جداسازی Train/Test بر اساس زمان بررسی شوند.
هفته سوم؛ Shadow Mode: مدل روی GX10 اجرا شود، ولی تیکت قطعی نسازد. هشدارها کنار نظر تعمیرکار ثبت شوند. Precision، Lead Time، نرخ هشدار و Latency اندازهگیری شوند.
هفته چهارم؛ Integration کنترلشده: هشدارهای معتبر به CMMS پیشنهادی وارد شوند، تأیید انسانی و Feedback تست شوند. قطع شبکه، خرابی Sensor، Rollback مدل و Backup نیز آزمایش شوند.
پایلوت باید با تصمیم پایان یابد: گسترش، اصلاح یا توقف. اگر Rule ساده نتیجه مشابه مدل پیچیده دارد، همان Rule کمهزینهتر را نگه دارید. اگر داده کافی نیست، خرید Sensor یا اصلاح Maintenance Log از خرید دستگاه دوم مهمتر است.
مشاهده یک خط واقعی مانند بازدید کارخانه انکر در شنژن یادآوری میکند که هر ایستگاه، تجهیز و تیم عملیاتی زمینه خودش را دارد؛ مدل یک کارخانه را نمیتوان بدون اعتبارسنجی به کارخانه دیگر منتقل کرد.
اشتباهات رایج پروژههای تعمیرات هوشمند
- شروع با همه تجهیزات: بدون اولویت Criticality و Failure Mode مشخص.
- Sensor نامعتبر: نصب شل، Range اشتباه یا Clock ناهماهنگ.
- داده بدون Context: نبود RPM، Load، Recipe و رخداد تعمیر.
- Label حدسی: نسبتدادن هر ناهنجاری به خرابی یاتاقان.
- اصرار بر RUL: بدون چرخه کافی تا خرابی واقعی.
- هشدار مستقیم: بدون تداوم، شدت و تأیید انسانی.
- نادیدهگرفتن Drift: تعمیر یا جابهجایی Sensor بهعنوان خرابی دیده میشود.
- ظرفیت روی کاغذ: تخمین تعداد ماشین از PFLOP بدون Load Test.
- قطع حلقه Feedback: نتیجه بازرسی از CMMS به Dataset برنمیگردد.
چکلیست پیش از بهرهبرداری
- دارایی، Failure Mode و هزینه توقف مشخصاند.
- اقدام پس از هر سطح هشدار تعریف شده است.
- حسگر، محل نصب، واحد، Sampling و Calibration ثبت شدهاند.
- RPM، Load و حالت کاری کنار سیگنال ذخیره میشوند.
- Data Gap و خرابی Sensor از ناهنجاری ماشین جدا میشوند.
- Train و Test بر اساس زمان یا دارایی از هم جدا هستند.
- Rule ساده با مدل AI مقایسه شده است.
- Precision، Recall، Lead Time و Alert Rate گزارش میشوند.
- تعمیرکار شواهد و امکان تأیید یا رد هشدار دارد.
- Feedback بازرسی و Work Order به Dataset بازمیگردد.
- Rollback مدل، Buffer Gateway و Backup تست شدهاند.
- ظرفیت با داده و نرخ واقعی چندروزه Benchmark شده است.
پرسشهای متداول
آیا ASUS Ascent GX10 مستقیماً به شتابسنج صنعتی وصل میشود؟
معمولاً DAQ، PLC یا Gateway واسط لازم است. رابط الکتریکی، Sampling دقیق، Driver و سازگاری ARM64 باید برای سختافزار انتخابی بررسی شوند.
آیا بدون داده خرابی میتوان مدل ساخت؟
میتوان Baseline سالم و Anomaly Detection ساخت، اما نوع خرابی یا RUL را بدون شواهد کافی نباید قطعی اعلام کرد. Feedback تعمیرکار به مرور Label معتبر میسازد.
لرزش بهتر است یا دما؟
به Failure Mode بستگی دارد. لرزش معمولاً تغییر مکانیکی سریعتری نشان میدهد و دما روند حرارتی را تکمیل میکند. ترکیب آنها همراه RPM و Load اغلب زمینه بهتری میسازد.
آیا GX10 میتواند خرابی را دقیقاً چند روز قبل اعلام کند؟
فقط اگر مدل RUL با چرخههای واقعی و شرایط مشابه اعتبارسنجی شده باشد. در شروع، هشدار روند و سطح سلامت قابل دفاعتر از وعده تاریخ دقیق است.
آیا دستگاه جای CMMS را میگیرد؟
خیر. GX10 تحلیل و مدل را اجرا میکند؛ CMMS مالک دارایی، دستور کار، قطعه، نیروی انسانی و تاریخچه تعمیر را مدیریت میکند. این دو باید از طریق API یا Integration کنترلشده متصل شوند.
برای چند صد ماشین یک GX10 کافی است؟
ممکن است برای Sampling سبک کافی باشد و برای لرزش پرسرعت کافی نباشد. فقط Benchmark نرخ واقعی، Pipeline کامل، Retention و Latency هدف پاسخ معتبر میدهد.
کلام آخر؛ هدف پیشبینی نیست، اقدام بهموقع است
نگهداری پیشبینانه با ASUS Ascent GX10 زمانی ارزش میسازد که از حسگر معتبر، Context عملیاتی، پردازش سیگنال ورژندار، مدل قابل ارزیابی و گردش کار تعمیرات تشکیل شود. قدرت GB10 و حافظه 128GB میتوانند توسعه و تحلیل چندوجهی را آسانتر کند، اما کیفیت Sensor و Maintenance Log مهمتر از اندازه مدلاند.
شروع درست یک ماشین و یک Failure Mode است. ابتدا Baseline و Rule ساده را بسازید، سپس Anomaly Detection و در صورت وجود Label، طبقهبندی خرابی را اضافه کنید. RUL را تا زمانی که تاریخچه کافی ندارید وعده ندهید و مدل را جای استاندارد ایمنی یا تجربه تعمیرکار قرار ندهید.
اگر هشدار همراه با شواهد به CMMS برسد، تکنسین آن را تأیید کند و نتیجه تعمیر دوباره به Dataset برگردد، GX10 از یک کامپیوتر AI به بخشی از چرخه یادگیری کارخانه تبدیل میشود. در غیر این صورت، حتی مدل دقیق نیز فقط نموداری جذاب و جدا از عملیات باقی میماند.


پاسخگوی سوالات شما هستیم
دیدگاهی وجود ندارد!