


آنچه خواهید خواند
- پاسخ کوتاه، چه زمانی دو GX10 بهتر از یک دستگاه است؟
- دو دستگاه مساوی یک کامپیوتر با حافظه 256GB نیست
- سه معماری که نباید با هم اشتباه شوند
- ConnectX-7 چه نقشی در اتصال دو ASUS Ascent GX10 دارد؟
- چکلیست شبکه قبل از اجرای مدل
- پشته نرمافزاری پیشنهادی برای کلاستر دوگرهی
- مدلها و Cache چگونه بین دو گره توزیع شوند؟
- اجرای مدل 405B روی دو GX10 دقیقاً چه معنایی دارد؟
- دو Replica چه زمانی از مدل 405B ارزش بیشتری دارند؟
- Load Balancing دو Replica چگونه طراحی شود؟
- امنیت کلاستر رومیزی از کجا شروع میشود؟
- بنچمارک درست برای یک و دو GX10
- آزمون خرابی که قبل از Production لازم است
- چه چیزی را مانیتور کنیم؟
- هزینه واقعی دستگاه دوم فقط قیمت خرید نیست
- ماتریس تصمیم: دستگاه دوم، Cloud یا مدل کوچکتر؟
- پایلوت 30 روزه برای اتصال دو ASUS Ascent GX10
- خطاهای رایج در ساخت کلاستر رومیزی GX10
- چکلیست نهایی پیش از خرید GX10 دوم
- پرسشهای متداول
- کلام آخر
اتصال دو ASUS Ascent GX10 چه امکاناتی ایجاد میکند؟
اتصال دو ASUS Ascent GX10 میتواند دو نتیجه کاملاً متفاوت داشته باشد: یا هر دستگاه یک ورژن مستقل از مدل را اجرا میکند و درخواستها میان آنها تقسیم میشوند، یا یک مدل بزرگ میان دو گره توزیع میشود تا کاری را انجام دهد که در حافظه یک دستگاه جا نمیگیرد. در حالت دوم، ایسوس و انویدیا امکان کار با مدلهایی تا رده 405 میلیارد پارامتر را برای پیکربندی دو دستگاه مطرح کردهاند؛ اما این عبارت بهتنهایی درباره Precision، طول Context، سرعت تولید یا آمادگی Production چیزی نمیگوید.
هر GX10 با GB10 Grace Blackwell و 128GB حافظه یکپارچه، یک سیستم کامل است. با وصلکردن دو واحد، سیستمعامل یک فضای ساده 256GB به برنامه نشان نمیدهد. نرمافزار باید مدل، KV Cache، داده یا Batch را آگاهانه بین دو گره تقسیم کند و هر مرحله وابسته به ارتباط شبکهای میشود. بنابراین خرید دستگاه دوم فقط وقتی منطقی است که محدودیت واقعی یک گره شناسایی شده باشد.
این راهنما معماری، شبکه، نرمافزار، بنچمارک، ریسک و هزینه کلاستر رومیزی را بررسی میکند. اگر هنوز با جایگاه دستگاه آشنا نیستید، ابتدا بررسی ASUS Ascent GX10 و معرفی پردازنده GB10 Grace Blackwell تصویر پایه مناسبی میدهند.
پاسخ کوتاه، چه زمانی دو GX10 بهتر از یک دستگاه است؟
| نیاز | معماری مناسب | ارزش دستگاه دوم | ریسک اصلی |
|---|---|---|---|
| کاربر و درخواست بیشتر با همان مدل | دو Replica مستقل و Load Balancer | معمولاً بالا و قابل اندازهگیری | نامتوازنشدن صفها |
| مدلی که روی یک گره جا نمیگیرد | Tensor یا Pipeline Parallel | بالا، اگر مدل واقعاً لازم باشد | هزینه ارتباط بین گرهها |
| Fine-tuning توزیعشده | Data/Model Parallel با Checkpoint | وابسته به روش و Dataset | پیچیدگی و زمان همگامسازی |
| دسترسپذیری بهتر | Replica فعال و Health Check | بالا برای سرویس حیاتی | وابستگیهای مشترک |
| صرفاً دو برابرشدن سرعت | نامشخص تا زمان Benchmark | تضمینشده نیست | Scaling کمتر از انتظار |
برای اغلب تیمها، شروع با دو Replica سادهتر و کمریسکتر از تقسیم یک مدل میان دو گره است. هر Replica مستقل میماند، خرابی یک دستگاه کل سرویس را متوقف نمیکند و Load Balancer میتواند گره ناسالم را از مدار خارج کند. مدل توزیعشده زمانی توجیه دارد که کیفیت یا Context مورد نیاز با مدل کوچکتر، Quantization مناسب یا یک گره تأمین نشود.
دو دستگاه مساوی یک کامپیوتر با حافظه 256GB نیست
حافظه هر GX10 به پردازنده همان دستگاه تعلق دارد. دادهای که روی گره اول قرار دارد برای مصرف گره دوم باید از مسیر شبکه منتقل شود. Framework توزیعشده وزنها، Activationها یا Cache را Shard میکند و برای هر مرحله پیام میفرستد. هرچه تبادل بیشتر باشد، تأخیر شبکه سهم بزرگتری از زمان پاسخ را میگیرد.
این تفاوت در محاسبه ظرفیت مهم است. جمع دو عدد 128GB سقف نظری منابع است، نه حافظه آزاد قابل استفاده برای وزن مدل. سیستمعامل، Runtime، Bufferهای ارتباطی، Workspace کرنلها و KV Cache از ظرفیت کم میکند. افزون بر آن، بعضی روشهای Parallelism بخشی از داده را روی هر دو گره تکرار میکند.
برای مثال، اگر وزن Quantized مدل در دو گره جا شود اما تقریباً تمام حافظه را مصرف کند، Context بلند یا چند درخواست همزمان ممکن است Out of Memory ایجاد کند. Quantization همچنان مهم است و باید کیفیت ورژن فشرده با داده فارسی یا تخصصی سنجیده شود. بحث محدودیتهای هوش مصنوعی محلی نشان میدهد که «اجراشدن» با «تجربه قابل استفاده» یکسان نیست.
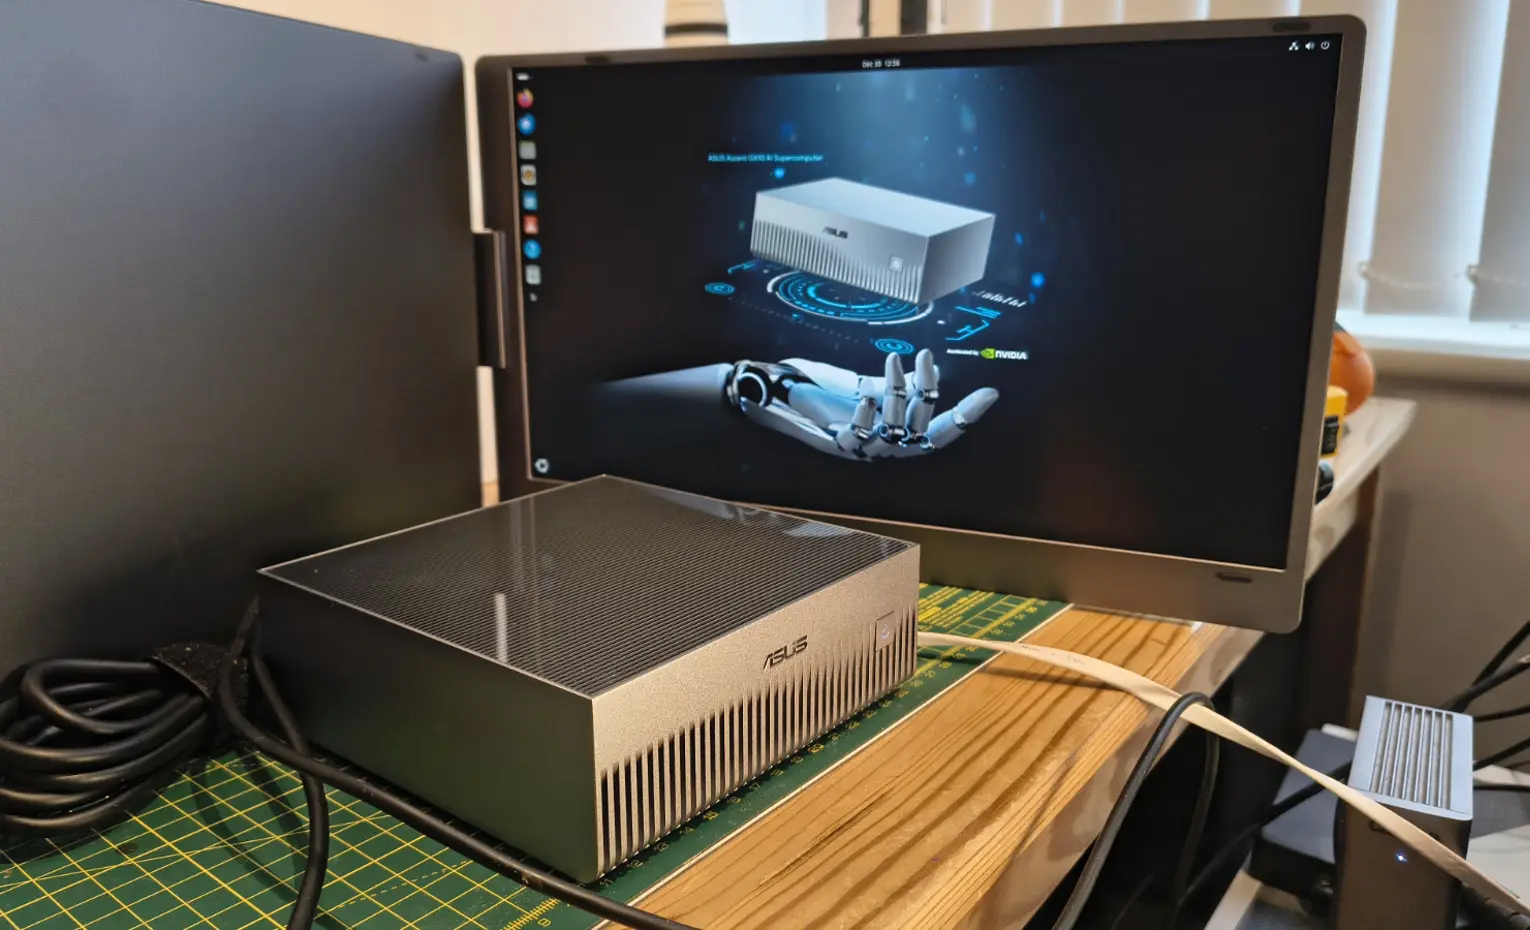
سه معماری که نباید با هم اشتباه شوند
1. دو Replica برای Throughput و پایداری
در این معماری هر GX10 کل مدل را بارگذاری میکند. Gateway درخواست جدید را بر اساس تعداد درخواست فعال، طول صف یا سلامت گره به یکی از دو Replica میفرستد. حافظه دستگاهها با هم جمع نمیشود، ولی ظرفیت سرویس میتواند افزایش پیدا کند. این مدل برای چت داخلی، RAG و API سازمانی انتخاب طبیعی است.
مزیت مهم، دامنه خرابی کوچکتر است. اگر Runtime روی یک گره Crash کند، گره دیگر میتواند بخشی از سرویس را نگه دارد. با این حال Load Balancer باید Streaming، Timeout و Session Affinity را درست مدیریت کند. فرستادن ادامه یک مکالمه به گره دیگر مشکلی ندارد اگر Context کامل در درخواست باشد؛ اما Cache محلی مشترک نیست.
2. یک مدل توزیعشده روی دو گره
در Tensor Parallel، محاسبات یک لایه میان شتابدهندهها تقسیم و خروجیها در نقاط مشخص همگام میشوند. در Pipeline Parallel، گروههایی از لایهها روی گرههای متفاوت قرار میگیرند و Activationها مرحلهبهمرحله عبور میکند. ترکیب دقیق به Runtime، مدل و Topology بستگی دارد.
این معماری امکان اجرای مدل بزرگتر را ایجاد میکند، اما یک درخواست به هر دو دستگاه وابسته است. خرابی یا کندی یکی از گرهها کل Job را تحت تأثیر قرار میدهد. همچنین TTFT و سرعت Decode میتوانند با ارتباط بین گرهها محدود شوند. ادعای رسمی پشتیبانی از مدل 405B باید در همین چارچوب فهمیده شود: ظرفیت مدل مطرح است، نه تضمین یک سطح معین از Latency یا Throughput.
3. آموزش یا Fine-tuning توزیعشده
در Data Parallel هر گره Batch متفاوتی میبیند و Gradientها همگام میشوند. در Model Parallel، وزن یا State مدل تقسیم میشود. Optimizer State، Gradient، Activation و Checkpoint میتوانند حافظهای بسیار بیشتر از وزن Inference نیاز داشته باشید. بنابراین مدلی که برای Inference روی دو GX10 اجرا میشود الزاماً برای Full Fine-tuning مناسب نیست.
روشهای PEFT مانند LoRA و QLoRA فشار حافظه را کاهش میدهند، اما ارتباط و I/O را حذف نمیکند. Dataset، طول Sequence، Batch مؤثر و فرمت Checkpoint باید از ابتدا ثبت شوند تا Run قابل پخش بماند. برای مبانی این مسیر، مقاله مدلها و اکوسیستم Mistral AI زمینه انتخاب مدل را تکمیل میکند.
ConnectX-7 چه نقشی در اتصال دو ASUS Ascent GX10 دارد؟
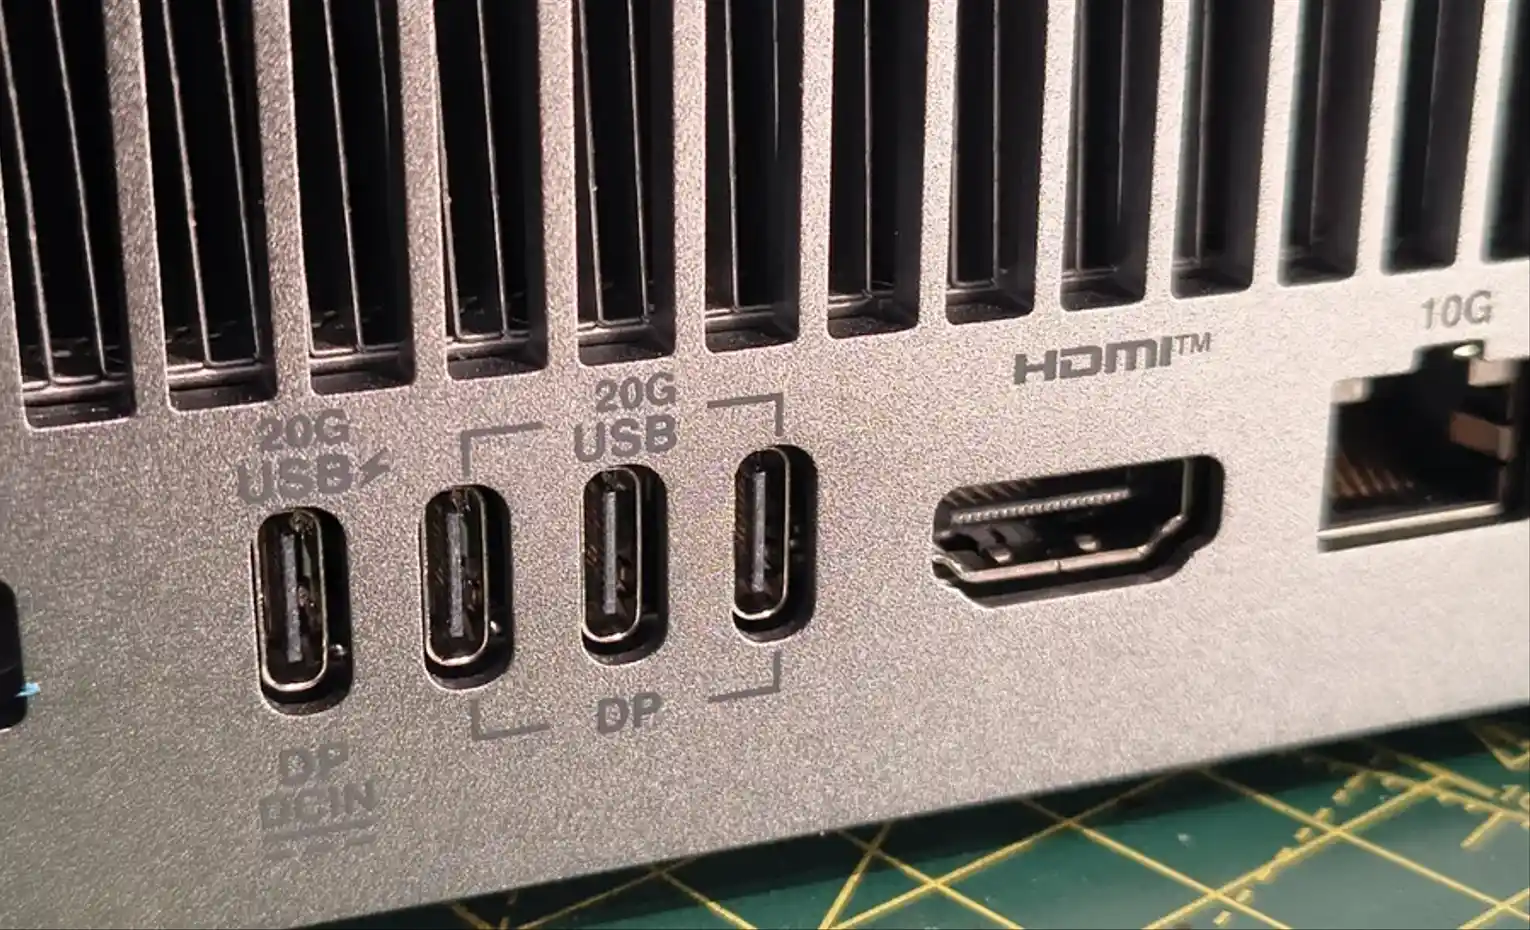
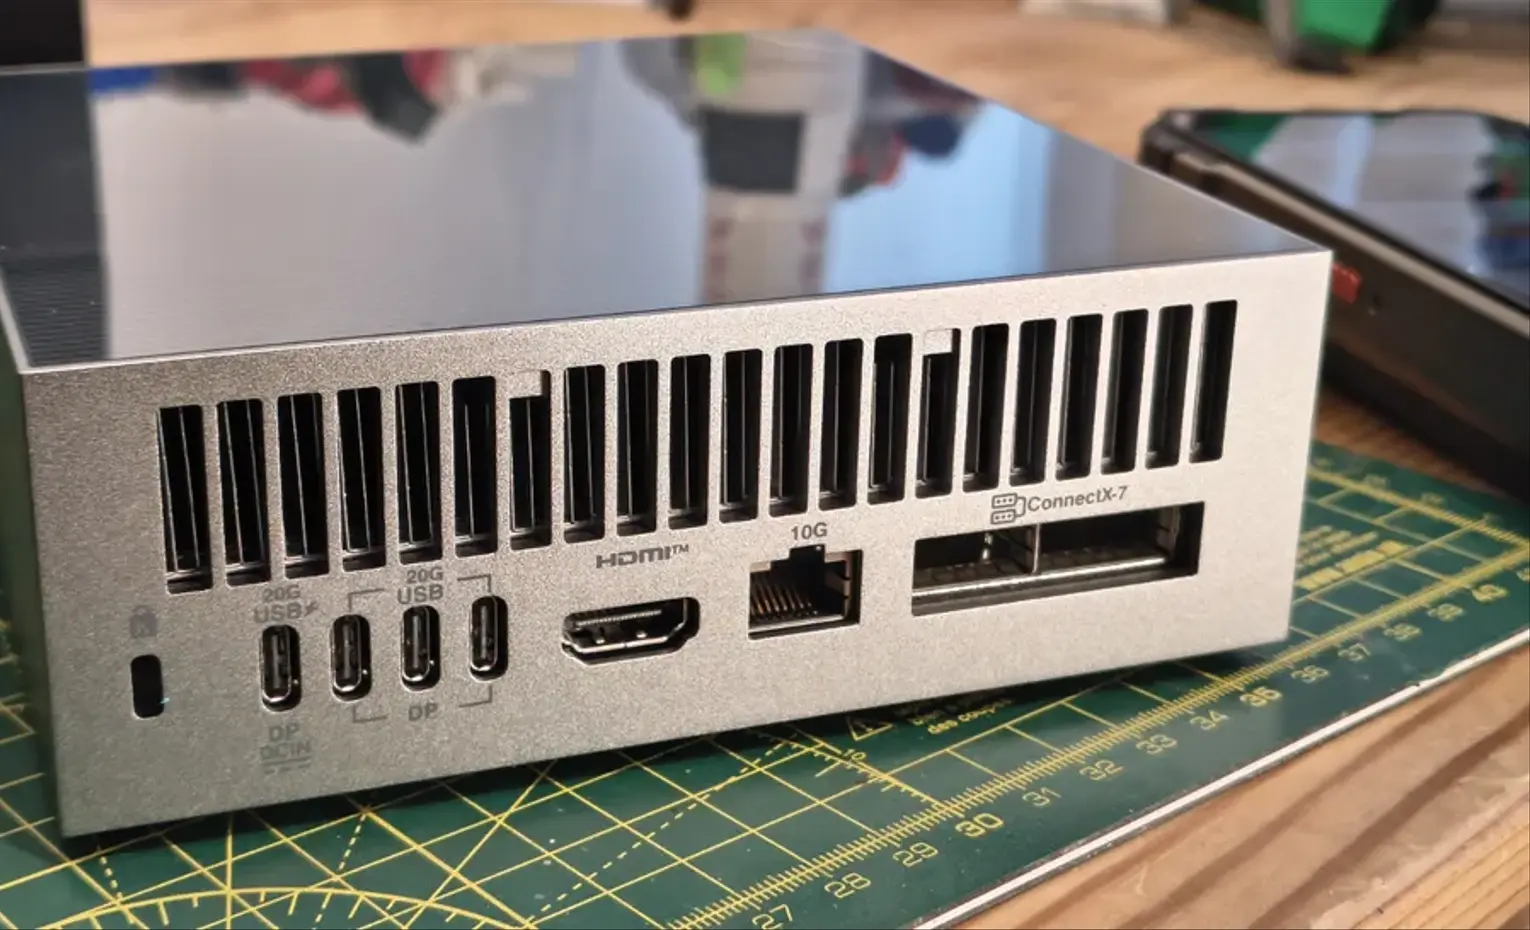
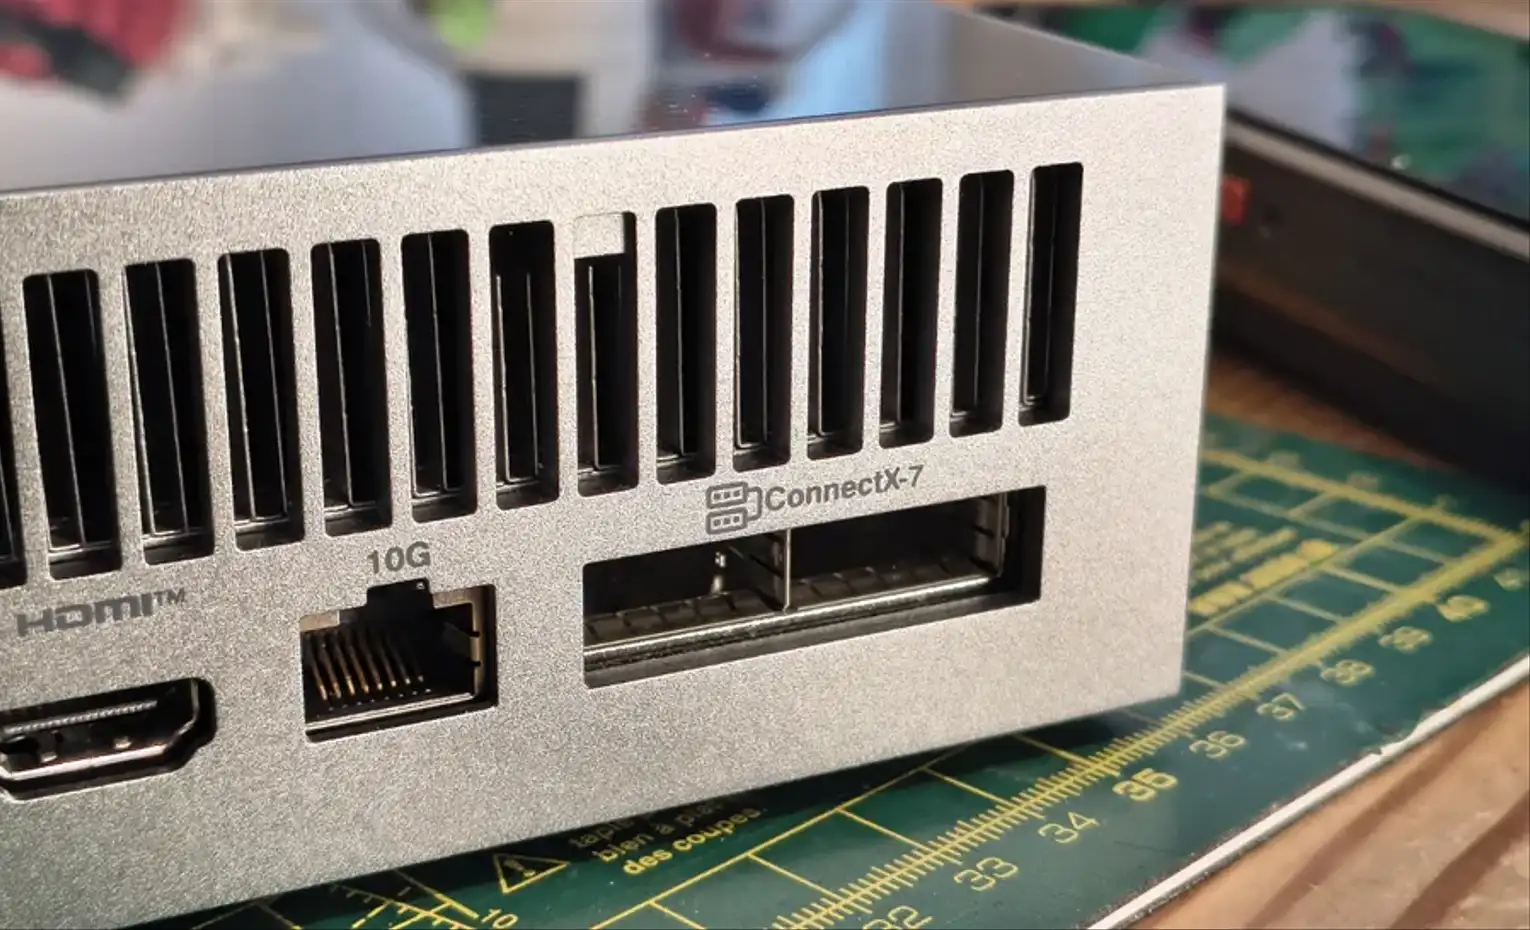
رابط 10GbE برای مدیریت، دسترسی کاربران، دریافت Artifact و ترافیک معمول شبکه مناسب است. ارتباط سنگین میان گرهها باید از مسیر پرسرعت ConnectX-7 و کابل سازگار انجام شود. مستندات رسمی پلتفرم DGX Spark برای اتصال مستقیم دو سیستم از QSFP استفاده میکند و برای هر پورت سرعت تا 200Gb/s را توضیح میدهد؛ مشخصات دقیق پورت، کابل، Firmware و حالت پشتیبانیشده در GX10 باید پیش از خرید از مستندات همان مدل و فروشنده تأیید شود.
بالابودن عدد Link کافی نیست. MTU، IP Addressing، Route، Interface Binding و تنظیم NCCL/UCX باید با Topology واقعی هماهنگ باشید. اگر Runtime رابط اشتباه را انتخاب کند، ترافیک Collective ممکن است از 10GbE عبور کند و کلاستر ظاهراً سالم اما بسیار کند باشد. آزمون پهنایباند و Latency پیش از Load مدل یک Gate ضروری است.
برای دو دستگاه، اتصال مستقیم سادهترین Topology است. توسعه به گرههای بیشتر معمولاً Switch سازگار، طراحی شبکه و بررسی مسیرهای اضافی میخواهد. از اعداد یا سقفهای مستندات DGX Spark نباید بدون تأیید به محصول ایسوس تعمیم قطعی داد؛ اشتراک پلتفرم GB10 راهنماست، نه جایگزین Support Matrix ایسوس.
چکلیست شبکه قبل از اجرای مدل
- مدل دقیق کابل، سرعت پشتیبانیشده و Firmware هر دو گره ثبت شود.
- هر گره روی شبکه مدیریت نام و IP پایدار داشته باشد.
- رابط ConnectX-7 برای مسیر داده آدرسدهی جداگانه و محدود داشته باشد.
- پهنایباند یکطرفه و دوطرفه، Latency و Packet Loss اندازهگیری شود.
- Runtime فقط به Interface مورد نظر Bind شود و Route واقعی بازبینی شود.
- ارتباط NCCL/UCX با Test کوچک قبل از وزن چندصد گیگابایتی اعتبارسنجی شود.
- Firewall فقط Portهای ضروری را باز کند و شبکه کلاستر در معرض اینترنت عمومی نباشد.
- نتیجه Test بهعنوان Baseline ذخیره شود تا افت بعدی قابل تشخیص باشد.
اشتباه متداول این است که Ping موفق معادل شبکه آماده تلقی شود. Ping فقط دسترسی پایه را نشان میدهد. Collective Communication الگوی ترافیکی متفاوتی دارد و میتواند از Binding نادرست، Buffer، Driver یا کابل نامناسب آسیب ببیند.
پشته نرمافزاری پیشنهادی برای کلاستر دوگرهی
| لایه | تصمیم لازم | مدرک قابل ثبت |
|---|---|---|
| سیستمعامل و Driver | ورژن یکسان و پشتیبانیشده | Image و ورژن Packageها |
| Container Runtime | Image ثابت با Digest | Manifest و SBOM |
| Model Store | ورژن وزن و Tokenizer | Checksum و Revision |
| Orchestrator | Ray، Script کنترلشده یا NIM | Config و Topology |
| Inference Engine | Tensor/Pipeline Parallel | پارامترهای Launch |
| Gateway | Auth، Queue و Timeout | Policy ورژنبندیشده |
| Monitoring | Metric، Log و Trace | Dashboard و Alert |
دو گره باید از نظر ورژن سیستمعامل، Driver، کتابخانه ارتباطی، Runtime و Model Artifact همسان باشید. عبارت «آخرین ورژن» برای عملیات کافی نیست، زیرا بهروزرسانی یک گره میتواند رفتار Collective یا Kernel را تغییر دهد. ورژنها باید Pin شوند و ارتقا ابتدا در محیط آزمایشی انجام شود.
Playbook رسمی NVIDIA برای vLLM چندگرهی از Ray برای گردآوری گرهها و Tensor Parallelism استفاده میکند. این یک مسیر مرجع است، نه ورژن واحد برای همه مدلها. هر مدل باید با معماری، Dtype و Backend پشتیبانیشده همان Release تطبیق داده شود. اگر هدف ساخت API است، مقاله ابزارهای ساخت Agentهای هوش مصنوعی کمک میکند مصرفکنده سرویس را از زیرساخت مدل جدا ببینید.
مدلها و Cache چگونه بین دو گره توزیع شوند؟
سه راه رایج برای نگهداری وزن وجود دارد. در روش اول، هر گره ورژن کامل Artifact را روی SSD محلی دارد؛ شروع سرویس سریع و وابستگی به Storage مرکزی کم است، اما فضا دو بار مصرف میشود. در روش دوم، وزن از Storage مشترک خوانده میشود؛ مدیریت ورژن آسانتر است ولی Startup همزمان میتواند گلوگاه بسازد. روش سوم Artifact را مرکزی نگه میدارد و پیش از Deploy به Cache محلی Sync میکند که معمولاً تعادل خوبی ایجاد میکند.
فقط نام فایل برای ورژنبندی کافی نیست. Revision مدل، Hash وزن، Tokenizer، Chat Template، تنظیم Quantization و مجوز استفاده باید کنار هم ثبت شوند. اگر Tokenizer دو گره متفاوت باشد، تقسیم یک Job یا مقایسه خروجی قابل اعتماد نیست. برای اطلاعات حساس، منبع Artifact، دسترسی و Audit نیز باید تعریف شوند.
KV Cache در Inference توزیعشده به Parallelism وابسته است. برخی بخشها Shard و برخی Metadataها تکرار میشوند. افزایش طول Context مصرف حافظه و هزینه Prefill را بالا میبرد؛ در نتیجه مدل 405B با Context کوتاه ممکن است Load شود اما با Context هدف کسبوکار ظرفیت مناسبی نداشته باشد.
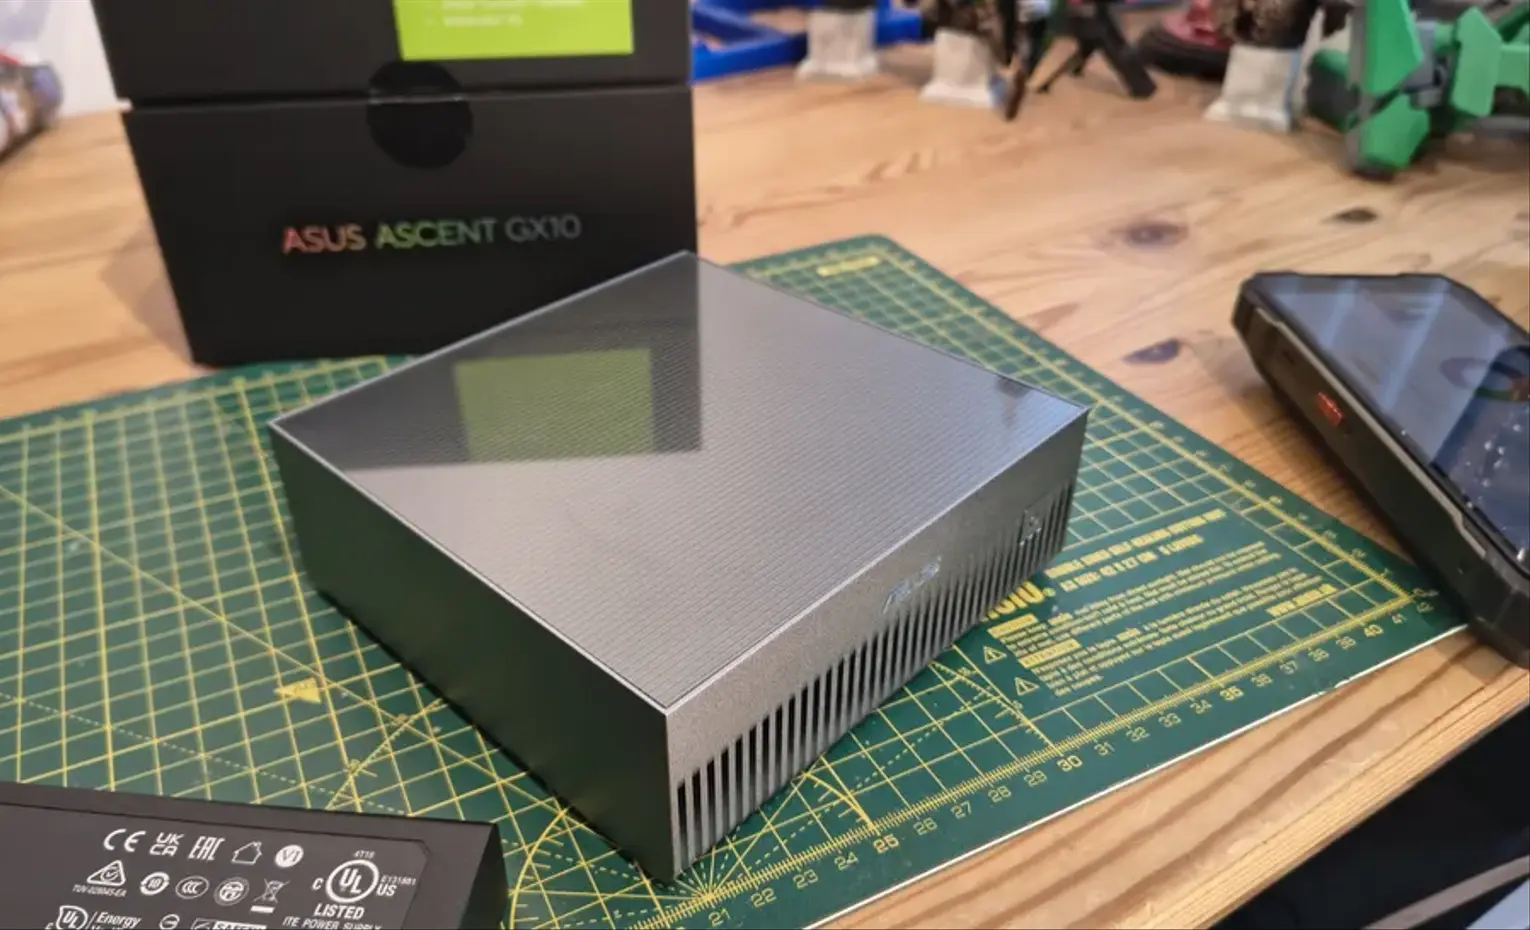
اجرای مدل 405B روی دو GX10 دقیقاً چه معنایی دارد؟
عدد 405B تعداد تقریبی پارامترهای مدل است، نه اندازه فایل ثابت. اندازه وزن به Precision و Quantization بستگی دارد. 405 میلیارد پارامتر در FP16 بهصورت ساده صدها گیگابایت وزن میخواهد و در ظرفیت دو گره جا نمیگیرد؛ بنابراین ادعای اجرای این رده مدل معمولاً به فرمت کمدقت یا Quantized و نرمافزار سازگار متکی است.
حتی پس از جاگرفتن وزن، سه بودجه باقی میماند: KV Cache برای Context، Workspace برای Kernelها و حافظه سیستم و Runtime. هر ورژن Quantized نیز از نظر کیفیت برابر نیست. ارزیابی باید مجموعهای از سؤالهای واقعی فارسی، داده تخصصی و سناریوهای Failure را شامل شود.
پشتیبانی از یک مدل ممکن است به معنای اجرای Batch یک، Context محدود یا Throughput آزمایشگاهی باشد. برای خرید سازمانی این سؤالها را مکتوب کنید: نام و Revision دقیق مدل چیست؟ فرمت وزن کدام است؟ Context آزمایش چند Token بوده؟ TTFT و سرعت Decode در چه Batch اندازهگیری شده؟ دما و مصرف توان پایدار بودهاند؟ بدون این جزئیات، «تا 405B» فقط یک سقف قابلیت است.
دو Replica چه زمانی از مدل 405B ارزش بیشتری دارند؟
بزرگترین مدل همیشه بهترین مدل کسبوکار نیست. اگر یک مدل 70B یا کوچکتر روی یک GX10 کیفیت هدف را تأمین کند، دستگاه دوم میتواند Replica دوم بسازد و Throughput، Maintenance Window و تحمل خرابی را بهبود دهد. این معماری برای سامانههایی که چند تیم از API استفاده میکند اغلب بازده عملیاتی بیشتری دارد.
با دو Replica میتوان مدلهای متفاوت هم اجرا کرد: یک مدل سریع برای طبقهبندی و Router، و مدل قویتر برای درخواستهای دشوار. همچنین میتوان یک گره را برای ورژن پایدار و دیگری را برای Canary Release نگه داشت. در این حالت ارتقا بدون قطع کامل سرویس آزمایش میشود.
برای RAG، گره دوم الزاماً نباید Replica همان LLM باشد. ممکن است ارزش بیشتری از اجرای Embedding، Reranker، OCR یا پردازش سند ایجاد کند. معماری باید از مسیر کار واقعی بیاید، نه از تقارن سختافزاری. تجربه NotebookLM و کار با منابع نیز اهمیت Pipeline کامل را نسبت به صرفاً اندازه مدل یادآوری میکند.
Load Balancing دو Replica چگونه طراحی شود؟
Round Robin ساده تفاوت طول Promptها را نمیبیند. یک درخواست با Context بلند میتواند گره اول را برای مدت زیادی مشغول کند، در حالی که گره دوم چند درخواست کوتاه دارد. معیار بهتر تعداد Sequence فعال، Tokenهای در صف، ظرفیت KV Cache و زمان تخمینی کار است.
Health Check باید دو سطح داشته باشد. Liveness میپرسد Process زنده است؛ Readiness بررسی میکند مدل Load شده و ظرفیت پذیرش درخواست دارد. گرهای که مدل را دوباره بارگذاری میکند نباید ترافیک بگیرد. Circuit Breaker نیز پس از خطاهای متوالی مسیر را موقتاً میبندد.
Queue نامحدود به جای افزایش ظرفیت، Latency را پنهان میکند. سقف صف، Timeout و پاسخ روشن 429 یا Busy تعیین کنید. برای کارهای غیرتعاملی، صف جدا و اولویت پایین مناسب است تا خلاصهسازی انبوه پاسخ چت را مختل نکند.
امنیت کلاستر رومیزی از کجا شروع میشود؟
شبکه ConnectX-7 باید بهعنوان شبکه داخلی کلاستر طراحی شود، نه رابط عمومی سرویس. Clientها از Gateway روی شبکه مدیریت یا شبکه برنامه وارد میشوند و فقط ترافیک بین گرهای از مسیر داده عبور میکند. دسترسی SSH با کلید، حساب محدود و ثبت رویداد انجام شود؛ اعتماد بدون رمز میان همه کاربران خطرناک است.
Token سرویس، کلید Registry و Credential Storage داخل Image یا Script قرار نگیرند. Secretها باید خارج از Artifact نگهداری و دورهای چرخانده شوند. Log نیز نباید Prompt، سند یا خروجی حساس را بهصورت پیشفرض ذخیره کند. شناسه درخواست، اندازه Token، Latency و کد خطا برای عیبیابی کافیاند مگر اینکه مجوز مشخص برای محتوای کامل وجود داشته باشد.
مدل دانلودشده یک وابستگی نرمافزاری است. منبع، مجوز، Hash و امکان کد سفارشی بررسی شوند. Container نیز باید اسکن و با Digest ثابت Deploy شود. راهنمای اصول امنیت برنامهها در بخش حداقلسازی دسترسی و حفاظت داده با همین معماری همراستاست.
بنچمارک درست برای یک و دو GX10
قبل از اتصال دستگاه دوم، Baseline تکگره با همان مدل، Precision، Context و ورژن نرمافزار ثبت شود. سپس دو معماری Replica و Distributed جدا آزمایش شوند. تغییر همزمان مدل و سختافزار نتیجه را غیرقابل تفسیر میکند.
| Metric | چرا مهم است؟ | نحوه مقایسه |
|---|---|---|
| TTFT | انتظار کاربر تا اولین Token | P50، P95 و P99 |
| Inter-Token Latency | روانی پاسخ Streaming | میدرنج و دنباله توزیع |
| Output Token/s | سرعت Decode هر درخواست | در چند سطح همزمانی |
| Aggregate Throughput | ظرفیت کل سرویس | Token/s کل و Request/min |
| Queue Time | نشانه اشباع | پیش از Runtime |
| Network Utilization | تشخیص گلوگاه ارتباط | هر Interface و جهت |
| Memory Headroom | ریسک OOM | در Context و Batch هدف |
| Error/Retry Rate | پایداری واقعی | آزمون طولانی و Failure |
Scaling دو برابر تضمین نیست. در Replicaها ممکن است Throughput به دو برابر نزدیک شود، اما Gateway، Storage یا بار نامتوازن مانع میشوند. در مدل توزیعشده، ارتباط Collective میتواند بخشی از سود Compute را مصرف کند و حتی Latency یک درخواست را نسبت به مدل کوچکتر تکگره افزایش دهد.
آزمون باید Warm و Cold Start، Prompt کوتاه و بلند، Batchهای مختلف و حداقل چند ساعت بار پایدار را پوشش دهد. فقط بهترین Run گزارش نشود. دما، توان و Throttling نیز ثبت شوند تا افت پس از چند دقیقه پنهان نماند.
آزمون خرابی که قبل از Production لازم است
کابل مسیر داده را در محیط کنترلشده قطع کنید و رفتار Job را ببینید. آیا Timeout روشن است یا درخواست بینهایت معطل میماند؟ Process یکی از گرهها را Restart کنید و زمان بازگشت Readiness را بسنجید. Storage مدل را موقتاً کند کنید تا مشخص شود Start همزمان چه اثری دارد.
در مدل توزیعشده معمولاً خرابی یک گره Job را متوقف میکند؛ Recovery به Restart هماهنگ نیاز دارد. در Replicaها، گره سالم باید ترافیک جدید را بگیرد، اما ظرفیت نصف میشود. Load Shedding لازم است تا ازدحام باقیمانده هر دو صف را از کار نیندازد.
برای Fine-tuning، Checkpoint باید دورهای و Atomic ذخیره شود. فایل ناقص نباید بهعنوان آخرین ورژن معتبر شناخته شود. بازیابی Checkpoint روی هر دو گره آزمایش شود، نه اینکه فقط وجود فایل بررسی شود.
چه چیزی را مانیتور کنیم؟
سه لایه Metric لازم است. در سطح سختافزار، حافظه، توان، دما، Utilization و شبکه دیده میشوند. در سطح Runtime، تعداد Sequence، KV Cache، Batch، Token و خطا ثبت میشود. در سطح کسبوکار، نرخ تکمیل موفق، زمان پاسخ و هزینه هر وظیفه سنجیده میشود.
داشبورد بدون Alert عملیاتی کافی نیست. Alert برای رشد پایدار صف، Memory Headroom پایین، افت پهنایباند، خطای Collective، Restart مکرر و تفاوت ورژن گرهها تعریف کنید. Threshold از Baseline و SLO میآید، نه عدد عمومی اینترنتی.
ظرفیت محلی را در کنار گزینه Data Center بسنجید. مقاله دیتاسنتر ۵ گیگاواتی متا و خبر همکاری OpenAI و Oracle برای دیتاسنتر مقیاس متفاوت زیرساخت Cloud را نشان میدهند؛ GX10 جایگزین آن مقیاس نیست، بلکه ابزار توسعه و استقرار کنترلشده نزدیک تیم است.
هزینه واقعی دستگاه دوم فقط قیمت خرید نیست
TCO شامل دستگاه، کابل سازگار، UPS، شبکه، Storage، برق، خنکسازی، زمان مهندسی و پشتیبانی است. اگر تیم تجربه Distributed Systems ندارد، هزینه عیبیابی میتواند از صرفهجویی Cloud بیشتر شود. از سوی دیگر، داده حساس، استفاده پیوسته و نیاز به کنترل ورژن میتوانند سرمایهگذاری محلی را توجیه کند.
برای مقایسه با Cloud، قیمت ساعتی خام کافی نیست. زمان Idle، انتقال داده، Storage، Reservation، نیروی عملیات و هزینه تأخیر پروژه را محاسبه کنید. هزینه محلی نیز بر اساس Utilization واقعی تقسیم شود. دستگاهی که فقط چند ساعت در ماه استفاده میشود ممکن است اقتصادی نباشد.
کمبود و نوسان بازار حافظه هم میتواند برنامه خرید را تغییر دهد؛ تحلیل شوک قیمت ناشی از کمبود جهانی حافظه نمونهای از ریسک زنجیره تأمین است. تصمیم خرید باید علاوه بر قیمت امروز، زمان تحویل و قطعه جایگزین را هم ببیند.
ماتریس تصمیم: دستگاه دوم، Cloud یا مدل کوچکتر؟
| شرایط | گزینه اول | دلیل |
|---|---|---|
| بار ثابت، داده حساس، مدل روی یک گره جا میشود | GX10 دوم بهصورت Replica | Throughput و تحمل خرابی |
| نیاز دائمی به مدل بسیار بزرگ Quantized | دو GX10 توزیعشده پس از Pilot | کنترل محلی و ظرفیت مدل |
| بار نادر و انفجاری | Cloud | پرداخت بر اساس مصرف و Elasticity |
| کیفیت با مدل کوچکتر تأمین میشود | یک GX10 و بهینهسازی | سادگی و هزینه کمتر |
| Full Training سنگین | زیرساخت GPU دیتاسنتری | حافظه و Interconnect مناسبتر |
| نیاز به Canary و سرویس بدون توقف | دو Replica | ارتقای مرحلهای |
اگر محدودیت فعلی با Quantization، کاهش Context، Reranker بهتر یا Routing حل میشود، دستگاه دوم شاید نخستین پاسخ نباشد. خرید سختافزار باید پس از اندازهگیری Bottleneck انجام شود. اتوماسیون سازمانی نیز به کل فرایند وابسته است؛ مقاله اتوماسیون سازمانی با هوش مصنوعی مایکروسافت نشان میدهد اتصال مدل به Workflow بخش مهم ارزش نهایی است.
پایلوت 30 روزه برای اتصال دو ASUS Ascent GX10
هفته اول: Baseline تکگره
سه مدل نامزد و دو سطح Quantization انتخاب کنید. Dataset آزمون شامل Promptهای واقعی، فارسی، طولهای مختلف و پاسخ مرجع باشد. TTFT، Throughput، کیفیت، حافظه و توان را ثبت کنید. یک مدل و تنظیم مبنا را Freeze کنید.
هفته دوم: شبکه و Replica
ConnectX-7، کابل و مسیر داده را اعتبارسنجی کنید. سپس همان مدل را روی هر دو گره بهصورت Replica اجرا کنید. Load Balancer را زیر بار متوازن و نامتوازن آزمایش و قطع یک گره را شبیهسازی کنید.
هفته سوم: مدل توزیعشده
فقط اگر نیاز واقعی وجود دارد، مدل بزرگ را با Tensor یا Pipeline Parallel راهاندازی کنید. مصرف حافظه هر گره، پهنایباند، TTFT و خطاهای Collective را بسنجید. نتیجه را با مدل کوچکتر تکگره و Replica مقایسه کنید.
هفته چهارم: عملیات و تصمیم مالی
Monitoring، Alert، Backup Config، Recovery و Patch را آزمایش کنید. هزینه مهندسی و انرژی را به TCO بیفزایید. در پایان یک Decision Record بنویسید: چه Workloadی، با کدام مدل و SLO، روی کدام معماری اجرا میشود و چه چیزی خارج از Scope است.
خطاهای رایج در ساخت کلاستر رومیزی GX10
- جمع ساده حافظه: تصور اینکه هر برنامه بدون Sharding به 256GB دسترسی دارد.
- استفاده ناخواسته از 10GbE: Runtime رابط مدیریت را برای Collective انتخاب میکند.
- ورژنهای متفاوت: Driver، Container یا Tokenizer دو گره همسان نیست.
- نادیدهگرفتن KV Cache: وزن Load میشود اما Context واقعی OOM ایجاد میکند.
- Benchmark تکدرخواست: ظرفیت صف و رفتار زیر بار دیده نمیشود.
- وعده Scaling دو برابر: ارتباط، Gateway و Storage محاسبه نمیشوند.
- SSH بیشازحد باز: راحتی راهاندازی به اعتماد گسترده و Secret ثابت تبدیل میشود.
- نداشتن Rollback: ارتقای یک گره کل کلاستر را ناسازگار میکند.
- انتخاب مدل بر اساس پارامتر: کیفیت واقعی فارسی و وظیفه کسبوکار سنجیده نمیشود.
چکلیست نهایی پیش از خرید GX10 دوم
- Bottleneck تکگره با Metric اثبات شده است.
- مدل کوچکتر یا Quantization مناسب کیفیت را تأمین نمیکند، یا Throughput دوم لازم است.
- سناریو Replica و مدل توزیعشده از هم تفکیک شدهاند.
- کابل، رابط، Firmware و سرعت پشتیبانیشده تأیید شدهاند.
- ورژنهای نرمافزاری و Model Artifact قابل پخشند.
- Benchmark با Context، Batch و زبان واقعی انجام شده است.
- Security Boundary، SSH، Secret و Logging طراحی شدهاند.
- Failure Test و Recovery موفق بودهاند.
- TCO با Cloud و یک Workstation بزرگتر مقایسه شده است.
- SLO و معیار توقف Pilot از قبل نوشته شدهاند.
پرسشهای متداول
آیا اتصال دو ASUS Ascent GX10 واقعاً 256GB حافظه میدهد؟
در مجموع دو دستگاه 256GB حافظه فیزیکی دارند، اما این ظرفیت بهصورت یک فضای حافظه ساده و مشترک در اختیار برنامه قرار نمیگیرد. Framework باید مدل و محاسبات را میان دو گره تقسیم کند و بخشی از ظرفیت نیز صرف Runtime، Cache و Buffer میشود.
آیا دو GX10 مدل 405B را اجرا میکند؟
ایسوس و انویدیا برای پیکربندی دو دستگاه، پشتیبانی از مدلهایی تا رده 405B را اعلام کردهاند. تحقق عملی به ورژن مدل، Quantization، Context، Runtime و تنظیم شبکه وابسته است. این ادعا تضمین سرعت یا آمادگی Production نیست.
آیا با دو دستگاه سرعت دقیقاً دو برابر میشود؟
خیر. دو Replica برای بار مستقل میتوانند Throughput را بهطور چشمگیری بالا ببرند، اما نتیجه به Load Balancing و گلوگاههای دیگر بستگی دارد. در یک مدل توزیعشده، ارتباط میان گرهها Scaling را محدود میکند.
10GbE برای اتصال دو دستگاه کافی است؟
برای مدیریت و ترافیک عادی مناسب است، اما کار توزیعشده سنگین بهتر است از مسیر ConnectX-7 و کابل سازگار استفاده کند. نوع کابل، سرعت و تنظیم دقیق باید برای GX10 تأیید و با آزمون اندازهگیری شود.
Ray و vLLM اجباری هستند؟
خیر. آنها یک مسیر رایج برای Orchestration و Inference چندگرهیاند. NIM یا Frameworkهای دیگر نیز ممکن است مناسب باشید. انتخاب باید با Support Matrix مدل و ورژن نرمافزار انجام شود.
برای RAG بهتر است مدل را تقسیم کنیم یا دو Replica بسازیم؟
اگر مدل روی یک گره جا میشود، Replica معمولاً سادهتر و پایدارتر است. گره دوم میتواند Embedding یا Reranking را نیز برعهده بگیرد. تقسیم مدل فقط وقتی لازم است که ظرفیت یا کیفیت با یک گره تأمین نشود.
مهمترین معیار خرید دستگاه دوم چیست؟
وجود یک محدودیت اندازهگیریشده که دستگاه دوم آن را رفع کند. این محدودیت میتواند حافظه مدل، Throughput، دسترسپذیری یا جداسازی محیط پایدار و آزمایشی باشد. علاقه به مدل بزرگ بهتنهایی معیار کافی نیست.
کلام آخر
اتصال دو ASUS Ascent GX10 میتواند یک کلاستر رومیزی جدی برای اجرای مدل بزرگ، افزایش ظرفیت API یا Fine-tuning کنترلشده بسازد. ارزش آن از انتخاب معماری درست میآید: Replica برای Throughput و پایداری، و Parallelism برای مدلی که روی یک گره جا نمیگیرد.
دو دستگاه حافظه خود را بهصورت جادویی یکی نمیکند. ConnectX-7، کابل و پشته ارتباطی باید درست پیکربندی شوند؛ ورژن نرمافزار و Artifact باید همسان بمانند؛ و نتیجه با TTFT، Throughput، کیفیت، حافظه، شبکه و آزمون خرابی سنجیده شود. اگر مدل کوچکتر یا Cloud نیاز را بهتر حل میکند، خرید دستگاه دوم الزاماً انتخاب برتر نیست.
رویه قابل دفاع این است: ابتدا Baseline تکگره، سپس دو Replica، و فقط در صورت نیاز مدل توزیعشده. این ترتیب ریسک را کم و ارزش واقعی GX10 دوم را قابل اندازهگیری میکند.


پاسخگوی سوالات شما هستیم
دیدگاهی وجود ندارد!