


آنچه خواهید خواند
- مرکز تماس هوشمند با ASUS Ascent GX10 چگونه ساخته میشود؟
- پیشنهاد مطالعه
- پاسخ سریع؛ زنجیره کامل از تماس تا اقدام
- GX10 دقیقاً چه نقشی در مرکز تماس دارد؟
- تفاوت پردازش پس از تماس و تحلیل زنده چیست؟
- واقعیت مهم درباره پشتیبانی فارسی روی GX10
- مرحله اول؛ اتصال امن به VoIP و ضبط تماس
- مرحله دوم؛ استانداردسازی و پاکسازی صوت
- مرحله سوم؛ ارزیابی ASR فارسی فراتر از WER
- مرحله چهارم؛ تشخیص گوینده و ساخت Transcript قابل استفاده
- مرحله پنجم؛ خلاصه تماس و ساخت تیکت با LLM
- مرحله ششم؛ سنجش کیفیت اپراتور بدون قضاوت سطحی
- مرحله هفتم؛ پیشنهاد پاسخ زنده به اپراتور
- آیا GX10 برای Voicebot فارسی مناسب است؟
- حریم خصوصی، رضایت و نگهداری تماس
- طراحی Storage و چرخه عمر داده
- ظرفیتسنجی واقعی ASUS Ascent GX10
- مقایسه استقرار Local، Hybrid و Cloud
- داشبورد مدیر مرکز تماس چه چیزی نشان دهد؟
- نقشه پایلوت 30 روزه مرکز تماس هوشمند
- خطاهای رایج و راه اصلاح
- چه زمانی GX10 انتخاب مناسبی نیست؟
- چکلیست پیش از بهرهبرداری
- پرسشهای متداول
- کلام آخر؛ از آرشیو صوت به فرایند قابل سنجش
مرکز تماس هوشمند با ASUS Ascent GX10 چگونه ساخته میشود؟
مرکز تماس هوشمند با ASUS Ascent GX10 از اتصال چند سرویس مستقل ساخته میشود: دریافت امن صدای تماس، تشخیص گفتار فارسی، تفکیک اپراتور و مشتری، پاکسازی متن، استخراج موضوع و تعهد، خلاصهسازی، کنترل کیفیت و ثبت نتیجه در CRM. GX10 میتواند این مدلها و سرویسها را داخل شبکه سازمان اجرا کند، اما خود دستگاه نه تلفنخانه است، نه نرمافزار مرکز تماس و نه مدل فارسی آماده با دقت تضمینشده.
پیشنهاد مطالعه
راه درست، شروع با پردازش تماس پس از پایان مکالمه است. ابتدا تماسهای ضبطشده به متن و خلاصه قابل بازبینی تبدیل میشوند؛ سپس دقت نام محصول، شماره سفارش، مبلغ، تاریخ و تعهد اپراتور سنجیده میشود. اگر کیفیت و ظرفیت ثابت شد، میتوان پیشنهاد پاسخ زنده، هشدار رعایت متن الزامی یا Voicebot را بهصورت مرحلهای اضافه کرد.
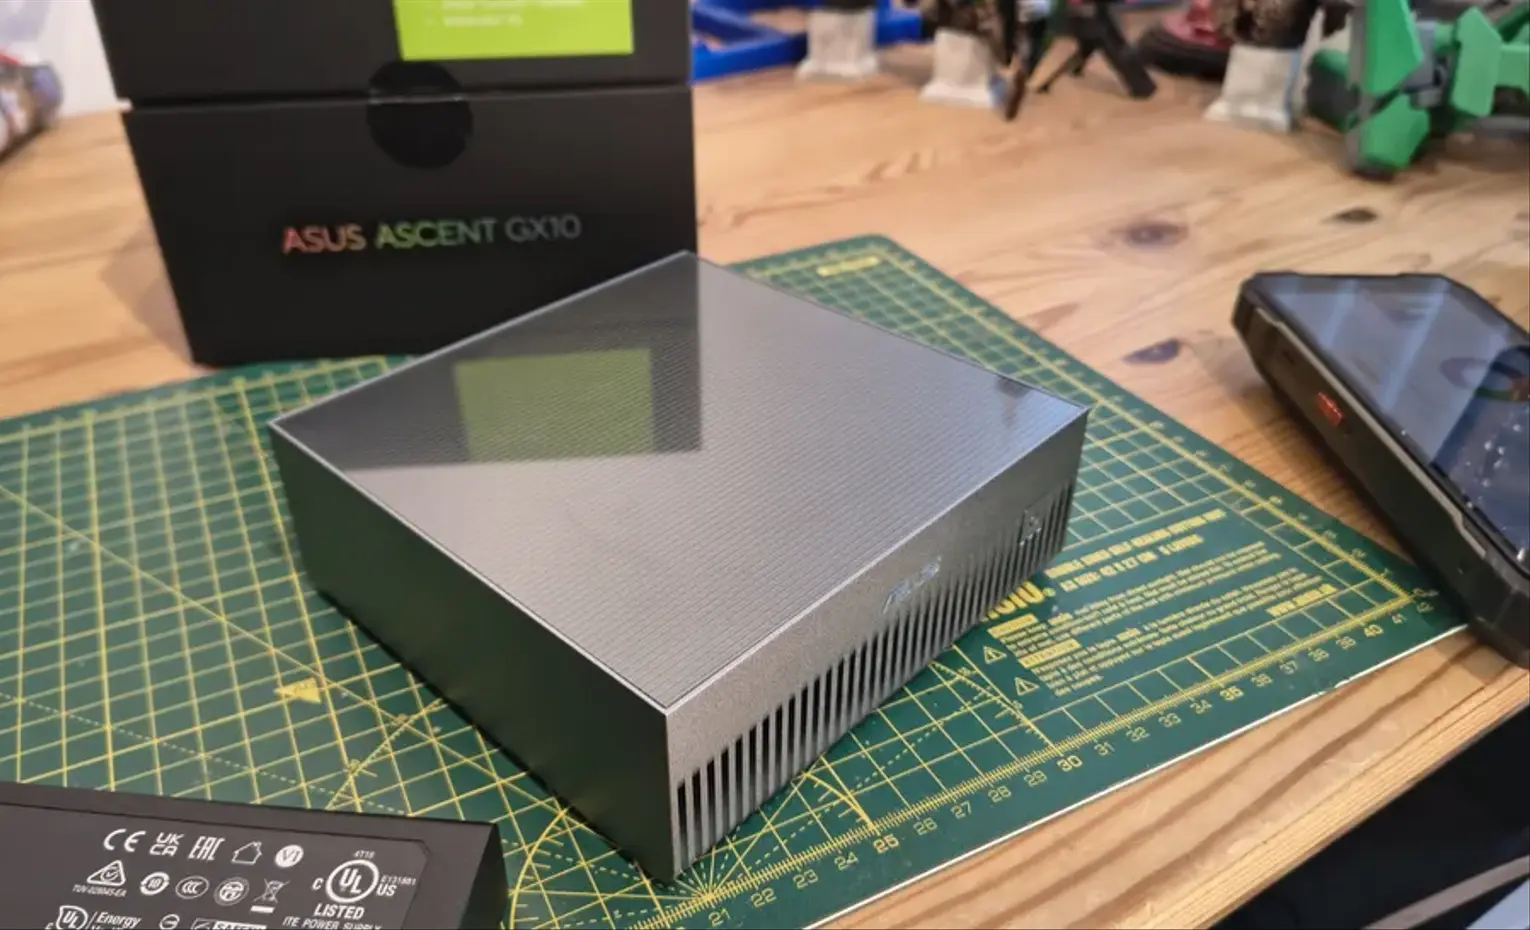
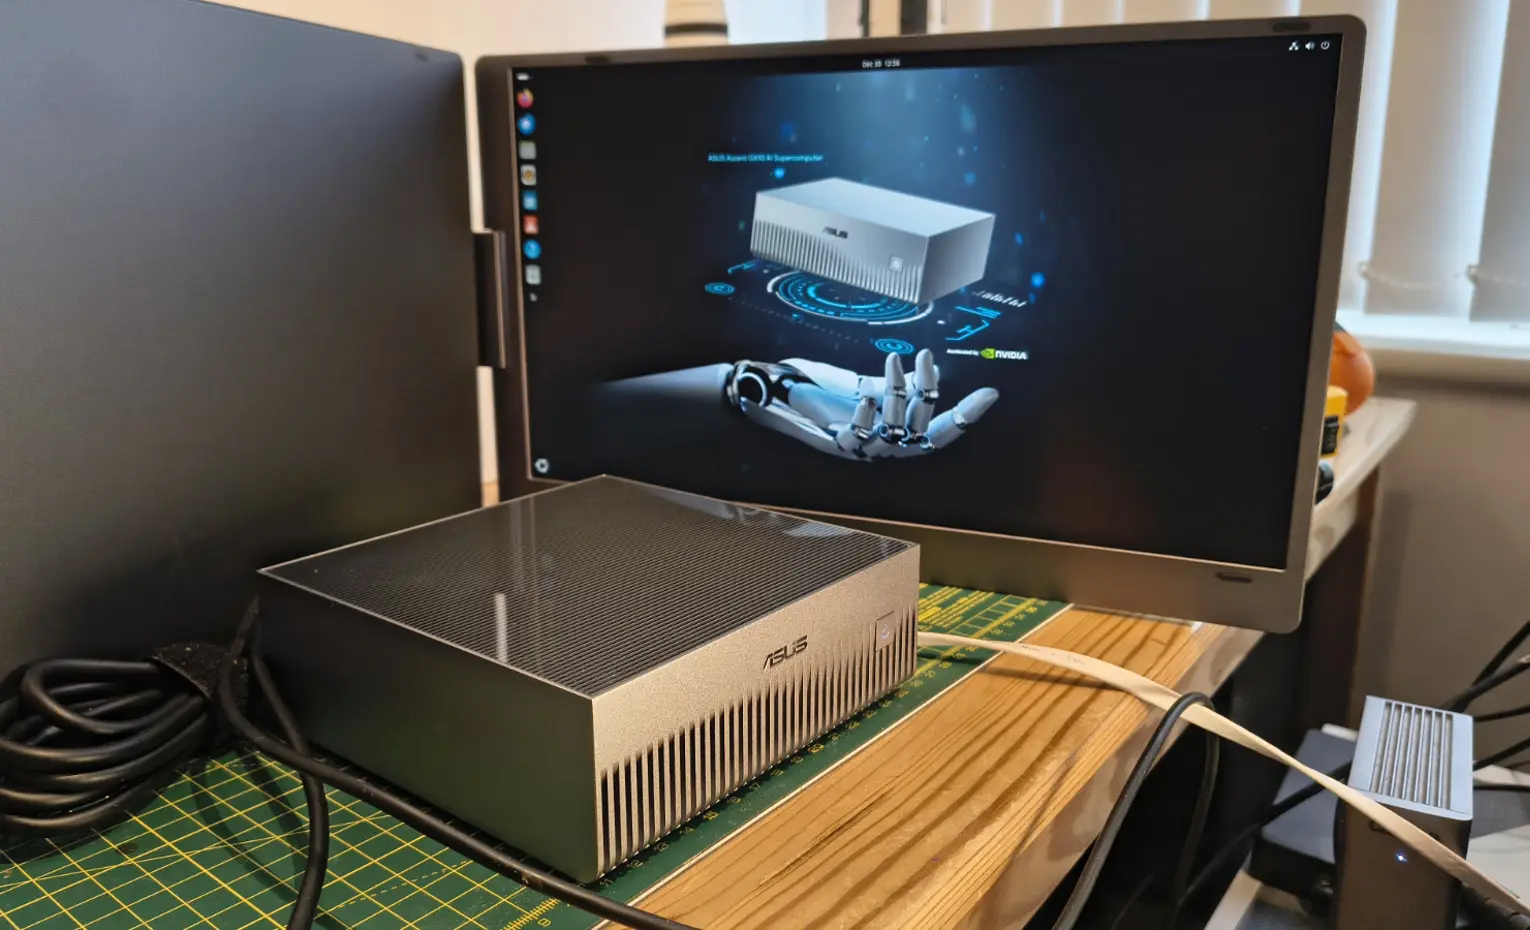
ورک استیشن هوش مصنوعی ایسوس مدل Ascent GX10 بر پایه NVIDIA GB10 Grace Blackwell ساخته شده و 128GB حافظه یکپارچه LPDDR5x، شبکه 10GbE و ConnectX-7 دارد. این مشخصات برای اجرای همزمان ASR، مدل زبانی و سرویسهای جانبی مهماند، اما تعداد تماس قابل پردازش فقط با Benchmark همان مدل، Codec و طول مکالمه مشخص میشود. برای شناخت معماری تراشه، مقاله پردازنده GB10 Grace Blackwell را بخوانید.
پاسخ سریع؛ زنجیره کامل از تماس تا اقدام
| مرحله | ورودی | خروجی | معیار اصلی |
|---|---|---|---|
| دریافت تماس | فایل یا Stream از VoIP | صدای استاندارد و شناسه تماس | کاملبودن و همگامبودن کانالها |
| آمادهسازی صوت | صدای خام | قطعههای گفتار و سکوت | حذفنشدن کلمات کوتاه و مهم |
| ASR | قطعه صوت | متن دارای Timestamp | WER و دقت موجودیتهای حیاتی |
| Diarization | یک یا دو کانال صدا | برچسب اپراتور و مشتری | DER و خطای تعویض گوینده |
| تحلیل متن | رونویسی | موضوع، نارضایتی، تعهد و نتیجه | Precision و Recall هر برچسب |
| خلاصهسازی | متن و Metadata | خلاصه و تیکت پیشنهادی | صحت واقعیت و پوشش نکات |
| یکپارچهسازی | خروجی تأییدشده | رکورد CRM، گزارش و هشدار | نرخ ثبت درست و قابلیت Rollback |
| نظارت | Log، بازخورد و خطا | داشبورد کیفیت و ظرفیت | Drift، Latency و نرخ بازبینی |
هر مرحله باید خروجی قابل مشاهده داشته باشد. اگر نام یک محصول در CRM اشتباه ثبت شد، تیم باید بداند خطا از صدای ورودی، ASR، نرمالسازی، مدل استخراج یا اتصال CRM آمده است. یک Pipeline یکتکه که فقط پاسخ نهایی را نشان میدهد، عیبیابی و ممیزی را دشوار میکند.
GX10 دقیقاً چه نقشی در مرکز تماس دارد؟
GX10 میتواند گره پردازشی داخل شبکه باشد. تلفنخانه یا پلتفرم VoIP فایل یا Stream را به یک Queue امن میفرستد؛ Workerها روی GX10 صدا را پردازش میکنند؛ ASR متن میسازد؛ مدل زبانی یا طبقهبند خروجی را تحلیل میکند و یک سرویس Integration نتیجه را به CRM یا سامانه تیکت برمیگرداند. کاربران معمولاً مستقیماً با سیستمعامل دستگاه کار نمیکنند و از داشبورد یا نرمافزار فعلی خود نتیجه را میبینند.
حافظه 128GB به تیم اجازه میدهد چند مدل را کنار هم بچیند، اما حافظه میان سیستمعامل، وزن مدلها، KV Cache، Batch، Queue و سرویسهای دیگر تقسیم میشود. ممکن است یک مدل ASR کوچک و یک LLM متوسط برای پردازش پس از تماس عملیتر از اجرای همزمان مدلهای بزرگ باشد. عبارت 1 PFLOP نیز سنجه Tensor Performance است و مستقیماً به «تعداد تماس در ساعت» تبدیل نمیشود.
استقرار شبکهای برای مرکز تماس طبیعیتر از استفاده دسکتاپی است. 10GbE میتواند جابهجایی آرشیو صوت و اتصال به Storage را تسهیل کند، ولی سرعت واقعی به NAS، Switch، تعداد فایلهای کوچک و روش خواندن همزمان وابسته است. اگر آرشیو چندساله دارید، SSD داخلی را محل دائمی همه تماسها فرض نکنید.
تفاوت پردازش پس از تماس و تحلیل زنده چیست؟
در حالت Batch یا پس از تماس، فایل کامل دریافت میشود و سیستم میتواند با تأخیر چند دقیقهای رونویسی، خلاصه و کنترل کیفیت را انجام دهد. این حالت سادهتر، ارزانتر و برای شروع کمریسکتر است. مدل کل مکالمه را میبیند، اصلاح گوینده آسانتر است و Queue میتواند بار ساعات شلوغ را بهتدریج تخلیه کند.
در حالت Streaming، صدا به قطعههای کوتاه تقسیم میشود و متن میانی در طول تماس برمیگردد. این روش برای پیشنهاد پاسخ، نمایش راهنمای محصول و هشدار عبارت ممنوع مفید است، اما Latency، پایداری شبکه، تشخیص پایان جمله و اصلاح متن موقت اهمیت بیشتری پیدا میکنند. متن میانی ممکن است با رسیدن صدای جدید تغییر کند؛ بنابراین نباید هر Token موقت را مستقیم در CRM ثبت کرد.
یک طراحی مرحلهای بهتر است: فاز اول خلاصهسازی پس از تماس، فاز دوم داشبورد نزدیک به زمان واقعی و فاز سوم Agent Assist زنده. Voicebot کاملاً خودکار باید پس از اثبات کیفیت ASR، مدیریت قطعکردن صحبت، انتقال به انسان و سیاست خطا بررسی شود.
واقعیت مهم درباره پشتیبانی فارسی روی GX10
پشتیبانی یک زبان در خانواده مدل، به معنی پشتیبانی همان مدل روی هر سختافزار و هر Container نیست. مستندات Riva فهرستی از مدلهای چندزبانه دارد و در مسیر Whisper کد زبان فارسی fa دیده میشود. در مقابل، Support Matrix فعلی ASR NIM برای پلتفرم DGX Spark فقط مدلهای مشخصی از Parakeet را پشتیبانی میکند و Whisper Large v3 را برای این پلتفرم پشتیبانیشده نشان نمیدهد.
چون ASUS Ascent GX10 از همان پلتفرم GB10 و معماری ARM64 استفاده میکند، نباید بدون بررسی نسخه، Container و Matrix سازگاری، وعده «Riva فارسی آماده روی GX10» داد. ممکن است تیم از Runtime یا مدل متنباز دیگری استفاده کند، ولی آن مسیر نیز باید روی ARM64، CUDA، Driver و Container واقعی آزمایش شود. نصبشدن یک Repository با اجرای پایدار Production برابر نیست.
در ارزیابی فارسی، فقط یک فایل استودیویی امتحان نکنید. تماس موبایل ضعیف، لهجه، همپوشانی گفتار، نام لاتین کالا، عدد، آدرس و نویز محیط باید در Dataset باشند. محتوای رونویسی زنده با HiDock نمونهای کاربرمحور از ارزش صوت به متن است، اما مرکز تماس سازمانی به معیار و کنترل بسیار سختتری نیاز دارد.
مرحله اول؛ اتصال امن به VoIP و ضبط تماس
منبع صدا میتواند فایل ضبطشده، Stream جداگانه دو طرف مکالمه یا خروجی یک Media Server باشد. بهترین حالت برای تحلیل، دو کانال مجزاست: یک کانال اپراتور و یک کانال مشتری. این ساختار بسیاری از خطاهای Diarization را کم میکند و اندازهگیری سکوت، قطع صحبت و سهم مکالمه را دقیقتر میسازد.
اگر فقط فایل Mono دارید، باید تشخیص گوینده اجرا شود. تماسهای کنفرانسی، انتقال تماس، موسیقی انتظار و ورود سرپرست این کار را دشوار میکنند. شناسه تماس، زمان، صف، داخلی اپراتور و رضایت یا مبنای قانونی ضبط باید همراه فایل منتقل شوند؛ نام فایل تصادفی بدون Metadata برای عملیات کافی نیست.
فایل ورودی را مستقیماً در پوشه مشترک بدون کنترل رها نکنید. Queue باید Retry، Idempotency و وضعیت پردازش داشته باشد. اگر Worker قطع شد، تماس نباید گم شود یا دوبار در CRM ثبت شود. Hash فایل و شناسه یکتای تماس برای تشخیص تکرار مفیدند.
برای کاربران نهایی، کیفیت هدست و مسیر صوتی همچنان مهم است. مقاله هدستهای حرفهای Jabra Evolve3 برای تماس اهمیت وضوح ورودی در ارتباط کاری را نشان میدهد و راهنمای آشنایی با انواع میکروفون تفاوت منابع صوتی را توضیح میدهد.
مرحله دوم؛ استانداردسازی و پاکسازی صوت
ASR باید ورودی مشخصی دریافت کند: Sample Rate، تعداد کانال، Codec و دامنه صدا نرمال شوند. تبدیل چندباره Codec میتواند جزئیات گفتار را از بین ببرد. صدای تلفنی معمولاً پهنای باند محدودتری از ضبط استودیویی دارد و همین موضوع تشخیص حروف نزدیک را سخت میکند.
Voice Activity Detection یا VAD گفتار را از سکوت جدا میکند. VAD تهاجمی ممکن است «بله»، «نه»، ابتدای نام یا رقم کوتاه را حذف کند؛ VAD شل نیز سکوت و نویز زیادی را برای مدل میفرستد. پارامترها باید روی تماس واقعی، نه پادکست تمیز، تنظیم شوند.
Noise Reduction همیشه مفید نیست. فیلتر شدید میتواند آواهای ضعیف را حذف و WER را بدتر کند. نسخه خام و نسخه پاکسازیشده را روی یک مجموعه ثابت مقایسه کنید. اگر Echo یا بازگشت صدا وجود دارد، ابتدا مسیر صوتی را اصلاح کنید؛ مقاله رفع اکو در تماس کامپیوتری منطق پیدا کردن مسیر بازگشت صدا را توضیح میدهد.
مرحله سوم؛ ارزیابی ASR فارسی فراتر از WER
Word Error Rate یا WER تعداد حذف، اضافه و جایگزینی واژه را نسبت به متن مرجع میسنجد. این معیار پایه لازم است، اما اهمیت همه واژهها یکسان نیست. اشتباه در «سلام» شاید اثر عملی کمی داشته باشد، ولی اشتباه در شماره سفارش، مبلغ، تاریخ یا نام محصول میتواند کل تیکت را خراب کند.
کنار WER، معیار Critical Entity Error Rate بسازید. فهرست موجودیتهای حیاتی شامل نام کالا، SKU، شماره تماس، مبلغ، تاریخ، کد پیگیری و عبارتهای تعهد باشد. برای هر مورد Precision، Recall و صحت مقدار ثبت شود. همچنین نرخ تشخیص جمله منفی مهم است؛ تفاوت «ارسال شده» و «ارسال نشده» با یک واژه کوچک ساخته میشود.
متن مرجع باید توسط انسان و با قاعده واحد برچسب بخورد. تصمیم بگیرید اعداد فارسی یا لاتین، نیمفاصله، علائم نگارشی و کلمات محاوره چگونه نوشته شوند. بدون Normalization، WER ممکن است دو شکل معادل را خطا حساب کند. نسخه Dataset و قواعد رونویسی باید ثبت شوند.
نمونهها را بر اساس صف، اپراتور، Codec، ساعت، لهجه و سطح نویز بخشبندی کنید. میانگین کلی میتواند ضعف یک گروه را پنهان کند. مدل باید در تماسهای دشوار سنجیده شود؛ نه فقط در نمونههایی که سیستم قبلاً روی آنها خوب عمل کرده است.
مرحله چهارم؛ تشخیص گوینده و ساخت Transcript قابل استفاده
Speaker Diarization مشخص میکند هر بخش را چه کسی گفته است. در تماس دوکاناله، برچسب از کانال میآید و قابل اعتمادتر است. در فایل تککاناله، مدل باید تغییر گوینده را حدس بزند و با صدای همزمان یا سکوت طولانی خطا میکند. معیار DER سهم زمانی خطای تفکیک گوینده را نشان میدهد.
Transcript نهایی باید Timestamp واژه یا جمله، برچسب گوینده، Confidence و ارتباط با فایل اصلی داشته باشد. اپراتور کنترل کیفیت باید با کلیک روی جمله به همان ثانیه صوت برسد. متن بدون امکان شنیدن منبع، بازبینی اختلاف را سخت میکند.
Punctuation و Inverse Text Normalization خوانایی را بهتر میکنند؛ مثلاً عبارت گفتاری عدد را به شکل عددی تبدیل میکنند. بااینحال تبدیل باید قابل برگشت یا ردیابی باشد. سیستم نباید شمارهای را حدس بزند و آن را مانند داده قطعی نمایش دهد.
برای درک زنجیره تبدیل صوت، متن و ترجمه، مقاله نحوه عملکرد ترجمه همزمان در هدفون نمایی ساده از اجزای Streaming ارائه میکند.
مرحله پنجم؛ خلاصه تماس و ساخت تیکت با LLM
مدل زبانی بهتر است یک Schema ثابت خروجی دهد: علت تماس، نتیجه، اقدام بعدی، تعهد اپراتور، مهلت، محصول، شماره سفارش و سطح نارضایتی. فیلد ناموجود باید Null باشد، نه حدس. خروجی JSON باید با Schema Validator بررسی شود و فقط پس از اعتبارسنجی وارد CRM شود.
مدل باید میان «درخواست مشتری»، «قول اپراتور» و «نتیجه قطعی» فرق بگذارد. جمله «بررسی میکنم شاید فردا ارسال شود» نباید به «ارسال فردا» تبدیل شود. برای هر فیلد مهم، Span یا Timestamp منبع نگه دارید تا کاربر بتواند دلیل استخراج را ببیند.
در فاز اول، تیکت پیشنهادی در حالت Draft نمایش داده شود و اپراتور آن را تأیید یا اصلاح کند. اصلاحات ارزشمندترین Dataset شما هستند: مشخص میکنند مدل کدام نام، دسته یا تعهد را اشتباه فهمیده است. ذخیره صرف دکمه مثبت و منفی برای بهبود کافی نیست.
اگر پاسخ به سؤال اپراتور به دانش محصول نیاز دارد، میتوان یک RAG جدا به دفترچه و مشخصات متصل کرد. معماری Agent و اتصال کنترلشده به ابزارها در مقاله ابزارهای ساخت Agent هوش مصنوعی توضیح داده شده است. مدل نباید قیمت یا موجودی را از حافظه بسازد؛ این دادهها باید از API زنده فروشگاه یا CRM خوانده شوند.
مرحله ششم؛ سنجش کیفیت اپراتور بدون قضاوت سطحی
کنترل کیفیت میتواند رعایت سلام و معرفی، احراز هویت، اعلام شرایط، ثبت تعهد، لحن حرفهای و جمعبندی تماس را بررسی کند. هر معیار باید تعریف عملیاتی و شاهد داشته باشد. «اپراتور مؤدب بود» مبهم است؛ «نام مشتری را قطع نکرد و عبارت الزامی را کامل گفت» قابل بررسیتر است.
تحلیل Sentiment بهتنهایی معیار عملکرد اپراتور نیست. مشتری ممکن است پیش از شروع تماس ناراضی باشد یا بهدلیل سیاست شرکت عصبانی بماند. مدل باید وضعیت ابتدا و انتهای تماس، علت تماس و اختیار واقعی اپراتور را در نظر بگیرد. امتیاز خودکار نباید بدون بازبینی مبنای تنبیه، حقوق یا اخراج شود.
نمونهای از هر امتیاز باید برای سرپرست قابل شنیدن باشد. اختلاف انسان و مدل ثبت و معیارها دورهای بازنگری شوند. Bias میان لهجه، جنس صدا یا سبک گفتار باید جدا آزمایش شود. هدف اولیه، یافتن تماس نیازمند بازبینی و فرصت آموزشی است، نه جایگزینی قضاوت انسانی.
مرحله هفتم؛ پیشنهاد پاسخ زنده به اپراتور
Agent Assist زنده میتواند موضوع را تشخیص دهد، صفحه راهنمای مرتبط را باز کند و پاسخ پیشنهادی بسازد. تأخیر اهمیت دارد: پیشنهادی که ده ثانیه دیر برسد مزاحم است. Pipeline باید متن میانی را دریافت کند، با Confidence پایین محتاط باشد و پیشنهاد را پس از تغییر Transcript اصلاح کند.
رابط کاربری نباید اپراتور را با چند کارت و هشدار همزمان شلوغ کند. یک پیشنهاد کوتاه، منبع روشن و دکمه بازکردن جزئیات بهتر از پاراگراف طولانی است. اپراتور باید بتواند پیشنهاد را نادیده بگیرد و سیستم از این رفتار بهتنهایی نتیجه نگیرد که محتوا غلط بوده است.
هر اقدامی که وضعیت مشتری را تغییر میدهد، مانند ثبت تخفیف، لغو سفارش یا تغییر آدرس، باید مجوز و تأیید مستقل داشته باشد. LLM میتواند پیشنهاد بسازد، اما ابزار عملیاتی باید ورودی را اعتبارسنجی و سطح دسترسی کاربر را کنترل کند.
آیا GX10 برای Voicebot فارسی مناسب است؟
از نظر معماری، GX10 میتواند ASR، مدل گفتگو و TTS را میزبانی کند. ولی Voicebot مسئلهای سختتر از خلاصهسازی تماس است: باید قطعکردن صحبت، سکوت، صدای همزمان، Intent مبهم، بازیابی اطلاعات و انتقال سریع به انسان را مدیریت کند. کیفیت هر جزء روی تجربه نهایی ضرب میشود.
TTS فارسی باید تلفظ نام برند، عدد، قیمت و آدرس را درست انجام دهد. مقاله بهبود صدای هوش مصنوعی با Piper TTS نشان میدهد تولید صدا نیز مدل و تنظیمات مستقل دارد. طبیعیبودن صدا کافی نیست؛ پیام باید درست، کوتاه و قابل قطع باشد.
بهتر است Voicebot ابتدا وظایف محدود مثل اعلام وضعیت سفارش از API یا ثبت درخواست تماس مجدد را انجام دهد. وقتی Confidence پایین است، کاربر چند بار تکرار نکند؛ مسیر خروج و انتقال به اپراتور باید همیشه روشن باشد.
حریم خصوصی، رضایت و نگهداری تماس
صدای تماس میتواند شامل نام، شماره، آدرس، اطلاعات خرید یا داده حساس باشد. ضبط و تحلیل باید بر اساس ضوابط سازمان، اطلاعرسانی مناسب و هدف مشخص انجام شود. نگهداری نامحدود «برای اینکه شاید بعداً لازم شود» ریسک را افزایش میدهد.
داده خام، Transcript، Summary، Embedding، Log و Backup هرکدام سیاست دسترسی و حذف میخواهند. حذف فایل صوتی درحالیکه Transcript و Cache باقی ماندهاند حذف کامل نیست. نقشهای سرپرست، تحلیلگر، توسعهدهنده و مدیر سیستم باید تفکیک شوند و دسترسی به تماسها ثبت شود.
اجرای محلی روی GX10 میتواند ارسال صوت به API عمومی را حذف کند، ولی امنیت کامل نمیسازد. حساب مشترک، داشبورد بدون TLS، Secret داخل کد یا Backup بدون رمز همچنان خطرند. برای زمینه گستردهتر، مقاله ضبط دائمی صدا و مسئله حریم خصوصی نشان میدهد خودِ جمعآوری صوت چه پرسشهایی ایجاد میکند.
طراحی Storage و چرخه عمر داده
یک دقیقه صدای فشرده ممکن است کمحجم به نظر برسد، اما هزاران ساعت تماس، نسخه خام و پردازششده، Transcript، Index و Backup سریعاً رشد میکنند. ظرفیت را بر اساس دقیقه روزانه، Codec، دوره نگهداری، ضریب نسخه و رشد سالانه محاسبه کنید.
SSD داخلی GX10 میتواند Workspace و Cache سریع باشد؛ آرشیو بلندمدت بهتر است روی Storage مدیریتشده با Snapshot، رمزگذاری و سیاست Tiering قرار گیرد. مسیر Hot برای تماسهای جدید، Warm برای بازبینی و Cold برای آرشیو طراحی شود. حذف باید از همه Tierها و Backupهای مشمول سیاست دنبال شود.
Index جستوجوی تماس نیز داده حساس دارد. حتی اگر صوت حذف شود، Embedding یا خلاصه ممکن است اطلاعات را بازتاب دهد. مالک داده باید بداند چه مشتقاتی ساخته شده و هرکدام چه زمانی حذف میشوند.
ظرفیتسنجی واقعی ASUS Ascent GX10
دو سؤال متفاوت را جدا کنید: «چند ساعت صوت Batch در یک ساعت پردازش میشود؟» و «چند Stream زنده با Latency هدف پشتیبانی میشود؟» Real-Time Factor برای ASR Batch نسبت زمان پردازش به طول صوت است. اگر پردازش یک ساعت صدا 15 دقیقه طول بکشد، RTF برابر 0.25 است؛ اما این عدد فقط برای همان مدل، Batch و سختافزار معتبر است.
در Streaming، صدک 95 Latency، تعداد Stream همزمان، نرخ قطع اتصال و مصرف حافظه مهماند. Diarization، Punctuation و مدل خلاصهساز را نیز در تست روشن نگه دارید. Benchmark فقط ASR خام ظرفیت کل محصول را نشان نمیدهد.
- Baseline: یک تماس کوتاه، متوسط و بلند را با Codecهای واقعی اجرا کنید.
- بار پلکانی: تعداد Worker یا Stream را تا نقطه افزایش شدید Latency بالا ببرید.
- آزمون ترکیبی: ASR، Diarization، LLM و ثبت CRM را همزمان بسنجید.
- آزمون طولانی: چند ساعت Queue واقعی اجرا کنید تا Leak و افت Storage دیده شود.
- ظرفیت امن: سقف عملی را زیر نقطه اشباع بگذارید و Queue و Failover تعریف کنید.
برای جلوگیری از تکیه بر عدد تبلیغاتی، مطلب تحلیل بازاریابی AI در پردازندهها یادآوری میکند که شاخص سختافزار باید به نتیجه کاربردی تبدیل شود.
مقایسه استقرار Local، Hybrid و Cloud
| روش | مزیت | محدودیت | سناریوی مناسب |
|---|---|---|---|
| Local روی GX10 | کنترل مسیر صوت و کار داخل شبکه | نیاز به نگهداری و سقف ظرفیت محلی | تماس حساس و بار قابل پیشبینی |
| Hybrid | پردازش حساس محلی و Burst کنترلشده | پیچیدگی Data Policy و دو محیط | نوسان بار یا نیاز گاهبهگاه به مدل خاص |
| Cloud | افزایش ظرفیت سریع و سرویس مدیریتشده | هزینه مصرف و بررسی حاکمیت داده | سرویس عمومی یا بار بسیار متغیر |
Hybrid میتواند ASR و حذف داده حساس را محلی انجام دهد و فقط متن پاکسازیشده را برای تحلیل خاص ارسال کند؛ یا پردازش عادی محلی باشد و Queue اضافی در اوج بار به Cloud برود. این مسیر فقط وقتی امن است که دقیقاً مشخص باشد چه دادهای، با چه مجوزی و برای چه مدت از سازمان خارج میشود.
مقایسه اقتصادی باید شامل هزینه دستگاه، برق، Storage، Backup، نگهداری، توسعه، مجوز نرمافزار، Downtime و ارتقا باشد. API ارزان در پایلوت ممکن است در حجم بالا گران شود و دستگاه محلی ارزان روی کاغذ ممکن است زمان تیم زیادی بگیرد.
داشبورد مدیر مرکز تماس چه چیزی نشان دهد؟
داشبورد خوب میان معیار عملیاتی و معیار مدل فرق میگذارد. حجم تماس، میانگین زمان مکالمه، صف و نرخ تماس مجدد معیار کسبوکارند؛ WER، DER، Latency و Confidence معیار Pipeline هستند. تغییر یک شاخص بدون دیگری میتواند علت متفاوتی داشته باشد.
مدیر باید بتواند از روند کل به نمونه تماس برسد، ولی دسترسی به صوت براساس نقش محدود شود. نمودارها بهتر است بازه، حجم نمونه و نسخه مدل را نشان دهند. پس از بهروزرسانی ASR، مقایسه قبل و بعد فقط روی تماسهای مشابه معتبر است.
خلاصه مدیریتی میتواند موضوعات پرتکرار، تعهدهای انجامنشده و فرصت آموزش را نشان دهد. مدل نباید از چند تماس محدود نتیجه قطعی درباره کل کارکنان بسازد. نمونهگیری، بازبینی انسانی و فاصله اطمینان در تصمیمهای مهم ضروریاند.
نقشه پایلوت 30 روزه مرکز تماس هوشمند
هفته اول؛ داده و معیار: یک صف مشخص انتخاب کنید، مجوز و سیاست نگهداری را روشن کنید و 20 تا 50 ساعت تماس نماینده جمع کنید. بخشی از تماسها بهصورت دقیق رونویسی و موجودیتهای حیاتی برچسب بخورند.
هفته دوم؛ ASR و گوینده: دو مدل یا دو تنظیم را روی Dataset ثابت مقایسه کنید. WER، خطای موجودیت، DER، سرعت و مصرف حافظه را ثبت کنید. سازگاری Runtime با ARM64 و نسخه Driver نیز همینجا اثبات شود.
هفته سوم؛ خلاصه و تیکت: Schema خروجی، Citation زمانی و حالت Draft در CRM را بسازید. اپراتور یا سرپرست اصلاحات را ثبت کند. مدل در نبود داده مقدار نسازد.
هفته چهارم؛ بار و امنیت: Queue ساعات اوج، قطع Worker، فایل تکراری، کاربر غیرمجاز و تماس حاوی داده حساس را تست کنید. نتیجه با زمان کار دستی، کیفیت فعلی و هزینه کل مقایسه شود.
معیار موفقیت میتواند کاهش زمان پسکار تماس، افزایش پوشش کنترل کیفیت و کاهش تیکت ناقص باشد. «متن جذاب مدل» معیار موفقیت نیست.
خطاهای رایج و راه اصلاح
- وعده فارسی بدون تست: مدل، Runtime و Support Matrix روی GX10 بررسی نشدهاند.
- شروع با Voicebot: پیش از آنکه رونویسی Batch و انتقال به انسان قابل اعتماد باشند.
- اتکا به WER کلی: خطای شماره سفارش و مبلغ پنهان میماند.
- یک فایل Mono برای همه: درحالیکه VoIP میتواند دو کانال مجزا ارائه کند.
- ثبت خودکار CRM: بدون Schema Validation، Idempotency و مرحله تأیید.
- Sentiment بهعنوان امتیاز کارمند: بدون زمینه تماس و بازبینی انسانی.
- نگهداری نامحدود: صوت، Transcript، Log و Backup سیاست حذف ندارند.
- Benchmark آزمایشگاهی: فایل تمیز بهجای تماس واقعی با نویز و لهجه استفاده میشود.
چه زمانی GX10 انتخاب مناسبی نیست؟
اگر فقط چند ساعت تماس در ماه دارید، یک سرویس آماده با قرارداد داده مناسب شاید اقتصادیتر باشد. اگر صدها Stream زنده، SLA سخت و چند شعبه دارید، یک دستگاه میتواند نقطه شکست واحد باشد و معماری چند Node یا Cloud لازم شود. اگر تیم Linux، امنیت و MLOps ندارید، هزینه نگهداری را دستکم نگیرید.
همچنین اگر مدل فارسی مطلوب روی پلتفرم ARM64 یا Container موردنظر پشتیبانی نمیشود، خرید سختافزار پیش از اثبات PoC ریسک دارد. ابتدا روی دستگاه نمونه یا محیط هممعماری، مسیر کامل را اجرا کنید. موفقیت یک LLM روی GX10، سازگاری خودکار ASR یا Diarization را ثابت نمیکند.
در مقابل، سازمانی با تماس حساس، بار مشخص و تیم فنی میتواند از پردازش محلی، کنترل داده و هزینه قابل پیشبینی سود ببرد. نتیجه باید با TCO و Pilot تعیین شود، نه با عنوان «سوپر کامپیوتر».
چکلیست پیش از بهرهبرداری
- قانون، اطلاعرسانی و هدف ضبط و تحلیل تماس مشخص است.
- فایل یا Stream دارای شناسه، Metadata و کانالبندی معتبر است.
- مدل فارسی روی GX10 و ARM64 عملاً اجرا و Benchmark شده است.
- WER، خطای موجودیت حیاتی و DER روی تماس واقعی سنجیده میشوند.
- خلاصه و تیکت دارای شاهد زمانی و حالت Draft هستند.
- اقدام CRM مجوز، Validation، Idempotency و Rollback دارد.
- صوت، Transcript، Embedding، Log و Backup سیاست حذف دارند.
- ظرفیت Batch و Streaming جداگانه Load Test شدهاند.
- مسیر انتقال به انسان و رفتار Confidence پایین تعریف شده است.
- نسخه مدل، Dataset و تنظیمات هر نتیجه قابل ممیزی هستند.
پرسشهای متداول
آیا GX10 مستقیماً به تلفنخانه وصل میشود؟
به یک لایه Integration نیاز دارد. تلفنخانه یا Media Server باید فایل یا Stream را از طریق رابط مجاز تحویل دهد و خروجی نیز از API کنترلشده به CRM یا سامانه تیکت برگردد.
آیا Riva فارسی روی GX10 تضمین شده است؟
خیر. فهرست زبان یک مدل و Matrix پشتیبانی آن روی DGX Spark یکسان نیستند. نسخه فعلی مستندات باید برای مدل و Container دقیق بررسی و مسیر فارسی روی سختافزار واقعی آزمایش شود.
برای شروع تحلیل زنده بهتر است یا پس از تماس؟
برای بیشتر سازمانها، پردازش پس از تماس نقطه شروع کمریسکتری است. پس از اثبات دقت، ظرفیت و Integration میتوان قابلیت زنده را اضافه کرد.
آیا یک مدل زبانی میتواند کیفیت اپراتور را قطعی تعیین کند؟
خیر. مدل میتواند تماس نیازمند بازبینی و شواهد را پیشنهاد دهد، اما امتیاز پرسنلی باید تعریف روشن، نمونه معتبر، کنترل Bias و تصمیم انسانی داشته باشد.
چند تماس همزمان روی GX10 پردازش میشود؟
به مدل ASR، حالت Streaming یا Batch، Codec، Diarization، Batch Size و مدل خلاصهساز بستگی دارد. پاسخ معتبر فقط از Load Test همان Pipeline به دست میآید.
آیا بعد از ساخت Transcript میتوان فایل صوتی را حذف کرد؟
این تصمیم تابع سیاست و نیاز ممیزی است. Transcript و مشتقات آن نیز داده حساساند و باید دوره نگهداری مستقل، دسترسی و حذف کنترلشده داشته باشند.
کلام آخر؛ از آرشیو صوت به فرایند قابل سنجش
مرکز تماس هوشمند با ASUS Ascent GX10 زمانی ارزش میسازد که یک فرایند واقعی را بهتر کند: پسکار تماس کوتاهتر شود، تیکت ناقص کاهش یابد، کنترل کیفیت از نمونه محدود به پوشش گسترده برسد و داده حساس تحت سیاست روشن باقی بماند. سختافزار GB10 و حافظه 128GB امکان میزبانی چند سرویس AI را فراهم میکنند، اما کیفیت فارسی، سازگاری مدل و ظرفیت همزمان تضمین آماده نیستند.
مسیر مطمئن از Batch آغاز میشود: صدای واقعی، متن مرجع، معیار WER و موجودیت، خلاصه دارای شاهد و ثبت Draft در CRM. پس از Load Test، کنترل دسترسی و بازبینی انسانی میتوان Agent Assist زنده یا Voicebot محدود را اضافه کرد. این ترتیب، GX10 را از یک دستگاه قدرتمند به زیرساختی برای مسئله حلشده تبدیل میکند.
پاسخگوی سوالات شما هستیم
دیدگاهی وجود ندارد!